Serwery DGX

Systemy z modułami SXM na płycie bazowej NVIDIA — osiem układów połączonych NVLinkiem pracuje jak jeden akcelerator ze wspólną pamięcią.

Przeglądaj katalog →
NVIDIA DGX
Systemy własne NVIDIA — kompletne węzły treningowe z fabryczną integracją.
Ampere
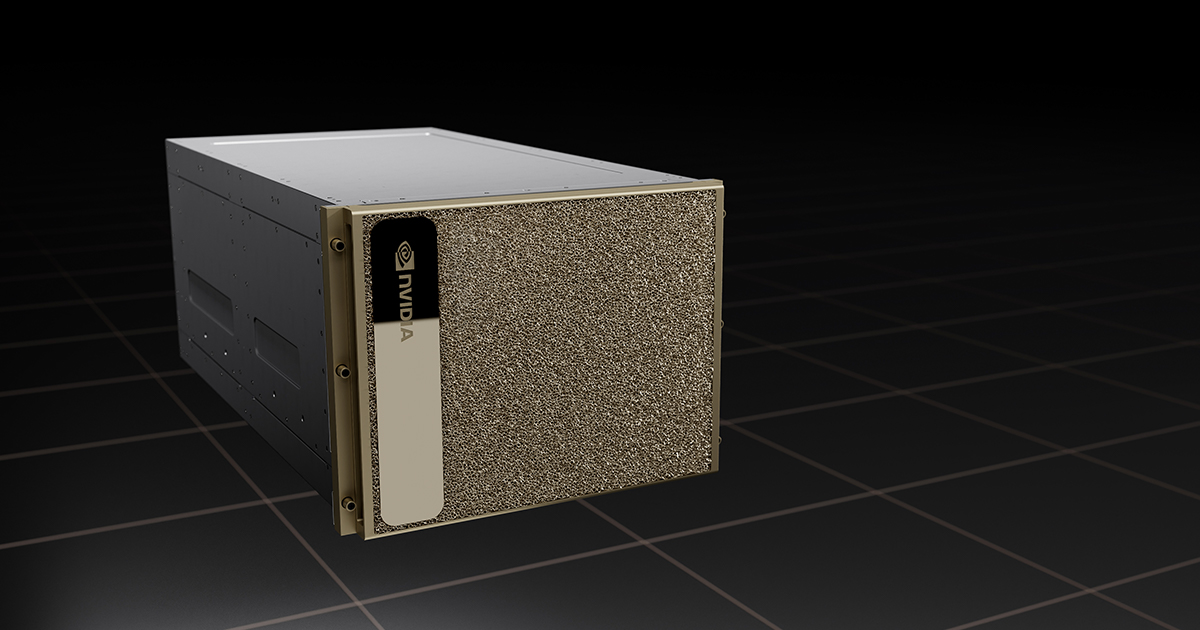
NVIDIA DGX A100 320 GB — front obudowy z panelem maskującym
Ampere
DGX A100 320 GB
ComputeEnterprise
Konfiguruj →
DGX A100 320 GB
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
NVIDIA DGX A100 640 GB — front obudowy z panelem maskującym
Ampere
DGX A100 640 GB
ComputeEnterprise
Konfiguruj →
DGX A100 640 GB
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
Hopper
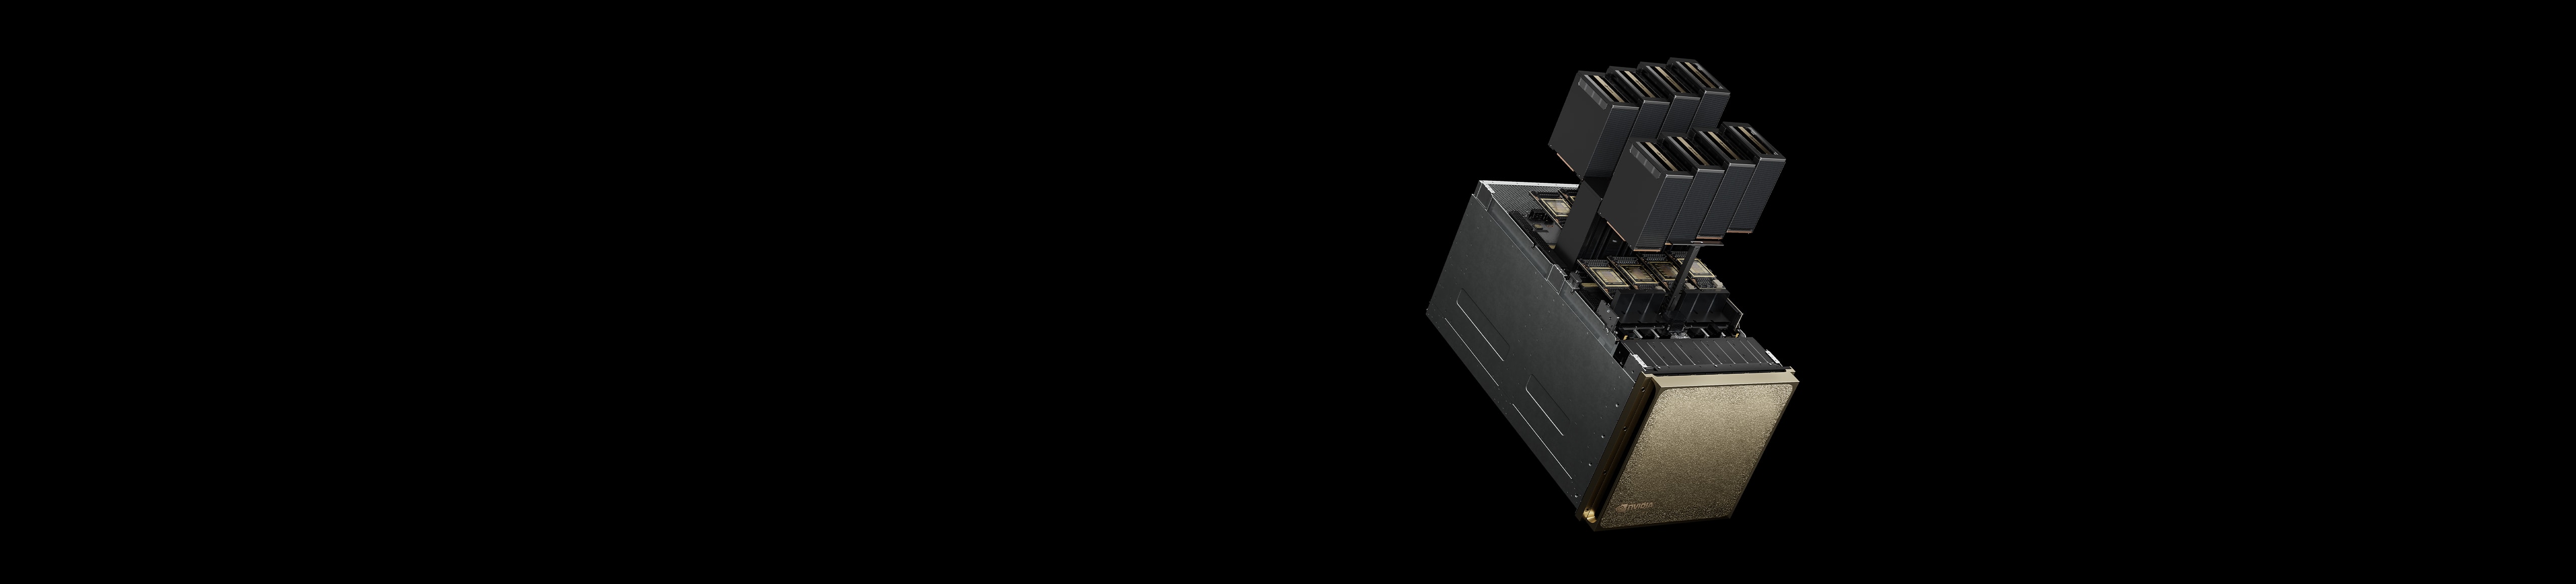
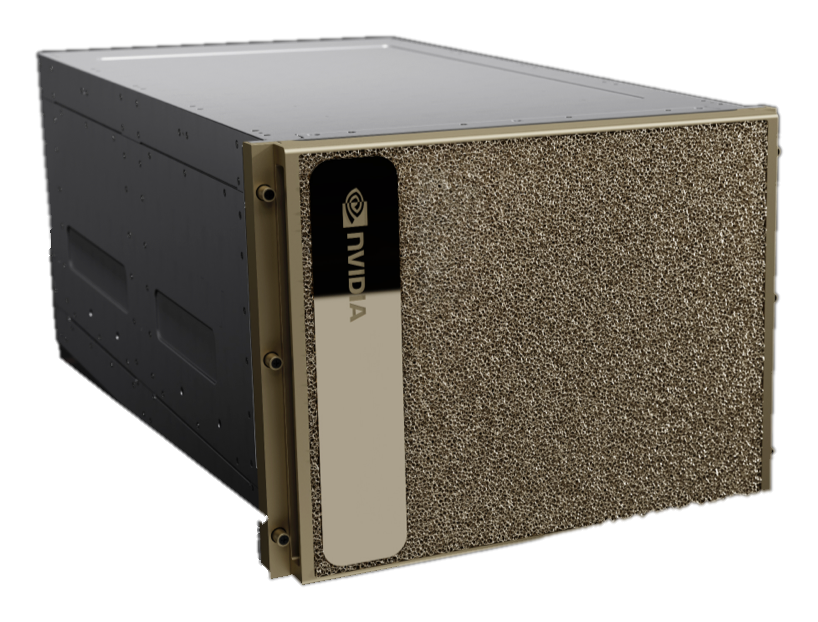
NVIDIA DGX H100 — oficjalny render 3/4 producenta
Hopper
DGX H100
ComputeEnterprise
Konfiguruj →
DGX H100
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
NVIDIA DGX H200 — oficjalny render 3/4 producenta
Hopper
DGX H200
ComputeEnterprise
Konfiguruj →
DGX H200
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
Blackwell
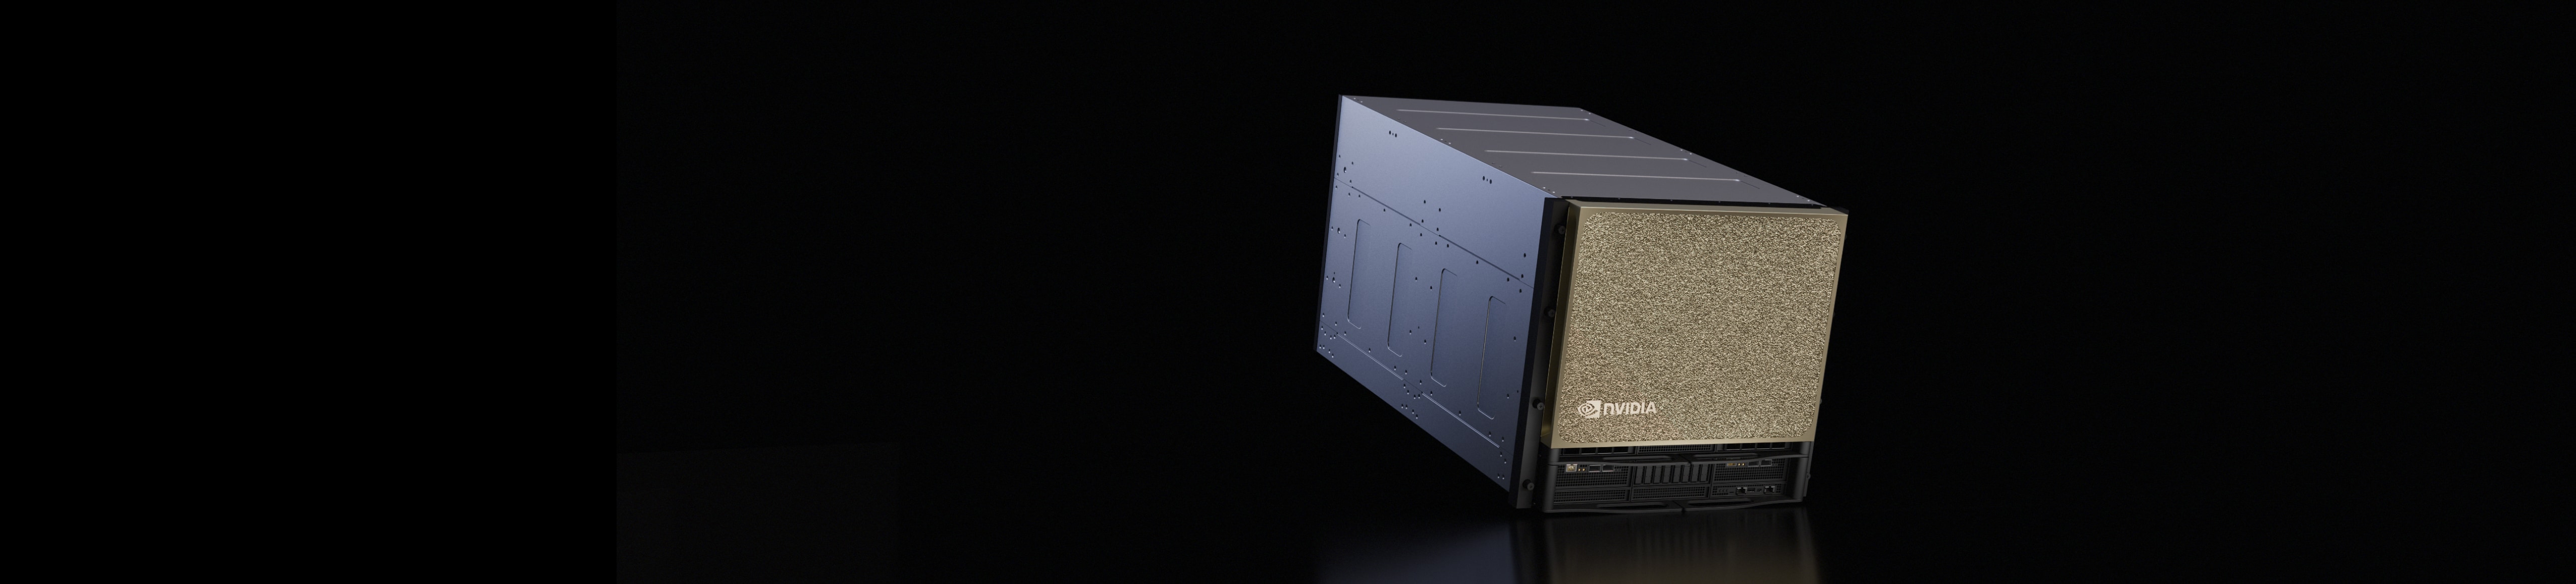
NVIDIA DGX B200 — oficjalny render 3/4 producenta
Blackwell
DGX B200
ComputeEnterprise
Konfiguruj →
DGX B200
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
NVIDIA DGX B300 — oficjalny render 3/4 producenta
Blackwell
DGX B300
ComputeEnterprise
Konfiguruj →
DGX B300
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
ASUS
Platformy ASUS na płycie bazowej NVIDIA HGX.
ESC N8 (HGX SXM5)
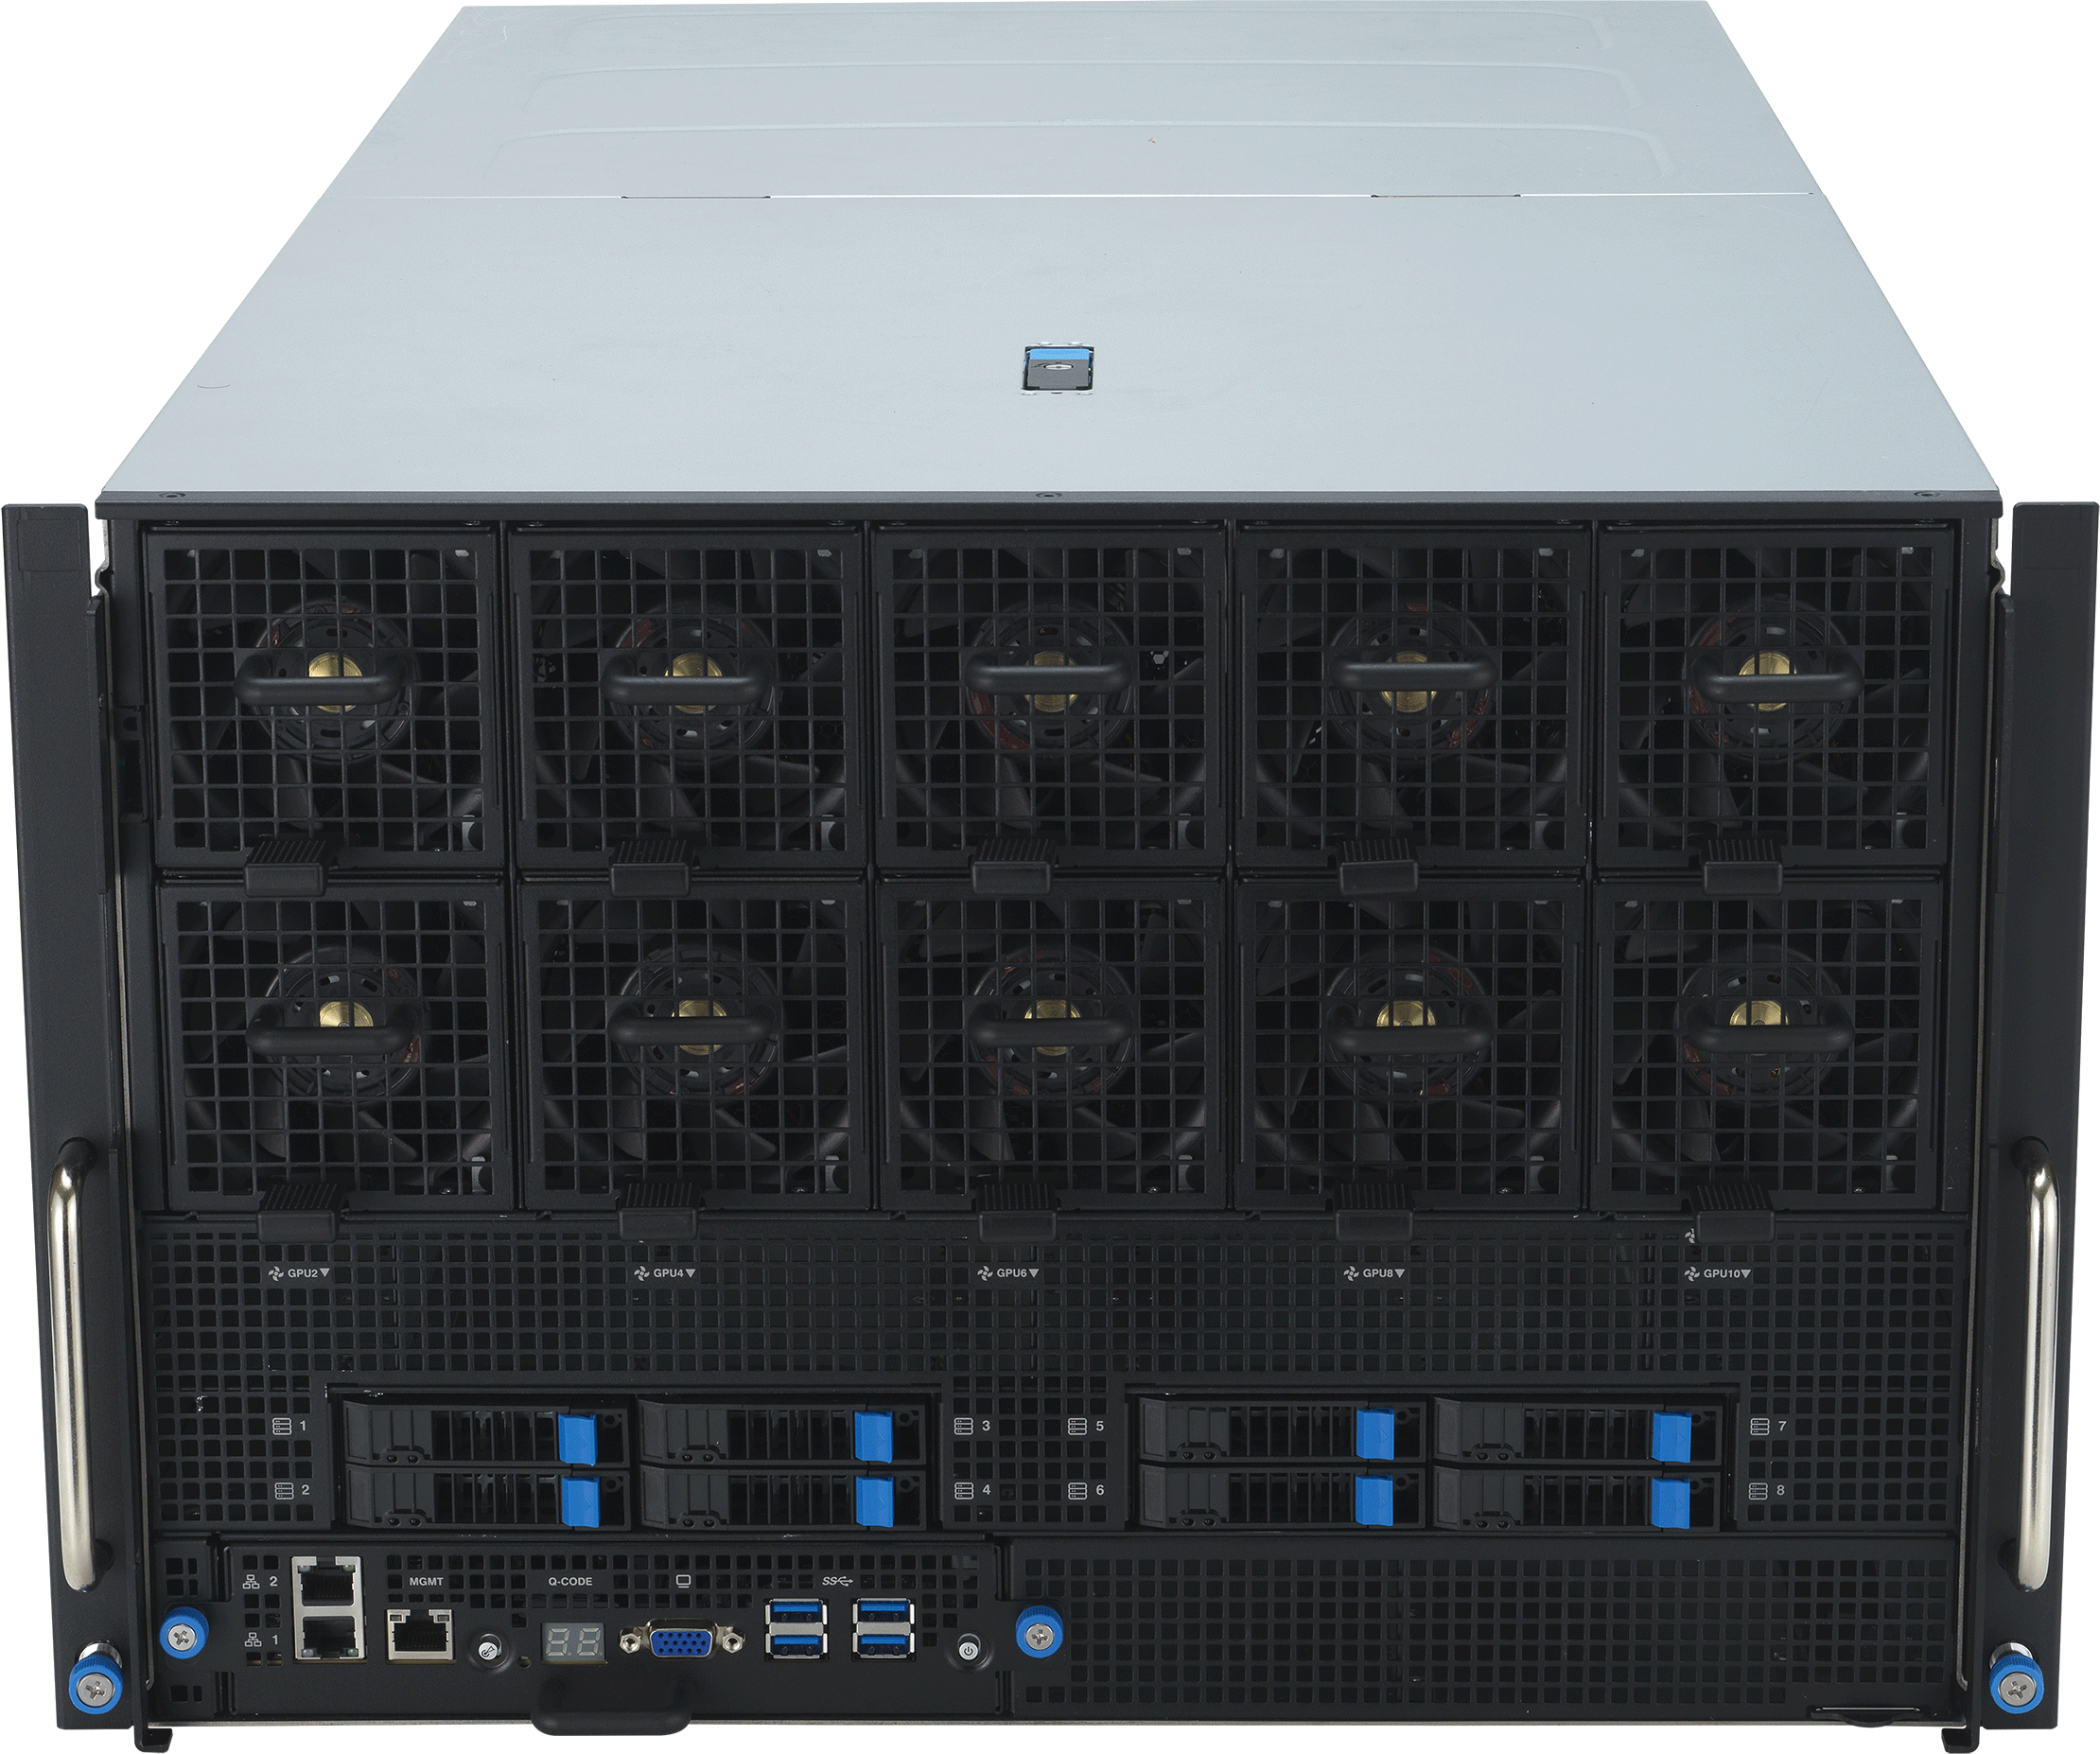
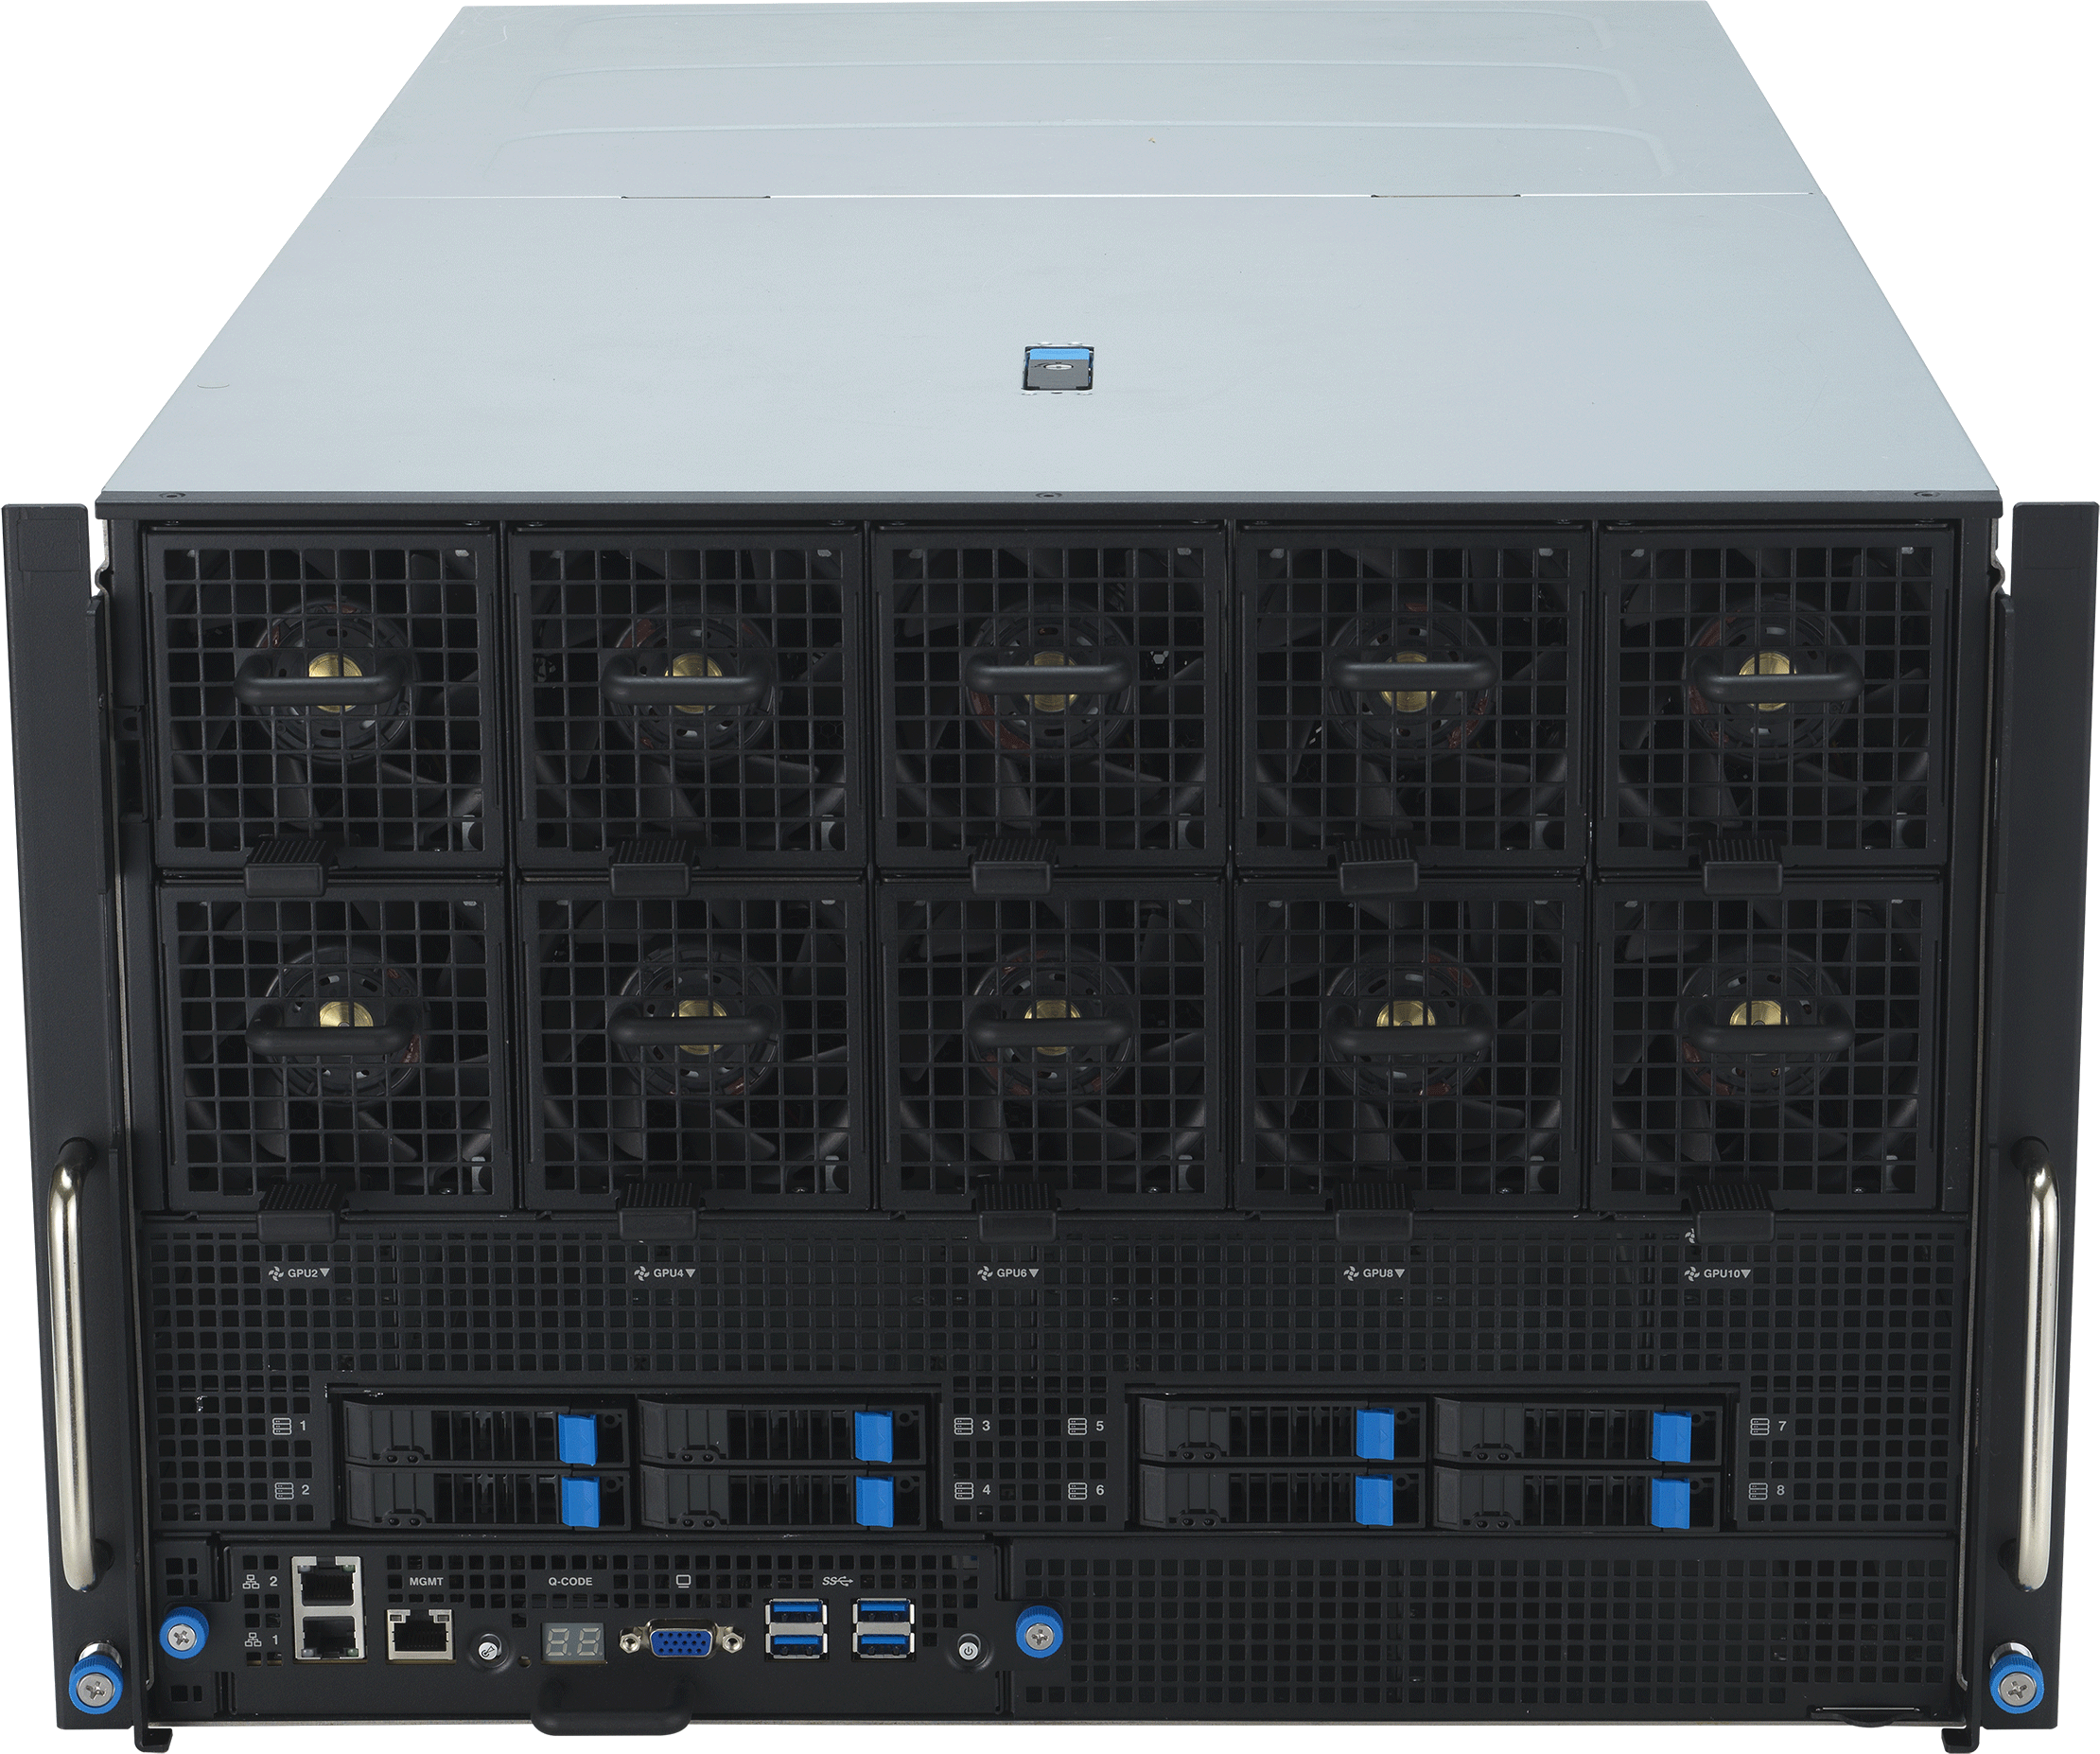
ASUS ESC N8-E11 — front z modułami wentylatorów i zatokami NVMe
ESC N8 (HGX SXM5)
ESC N8-E11
ComputeEnterprise
Konfiguruj →
ESC N8-E11
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
ASUS ESC N8-E11V — front z modułami wentylatorów i zatokami NVMe
ESC N8 (HGX SXM5)
ESC N8-E11V
ComputeEnterprise
Konfiguruj →
ESC N8-E11V
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
Gigabyte
Platformy Gigabyte G593 na płycie bazowej NVIDIA HGX.
G593 (HGX)
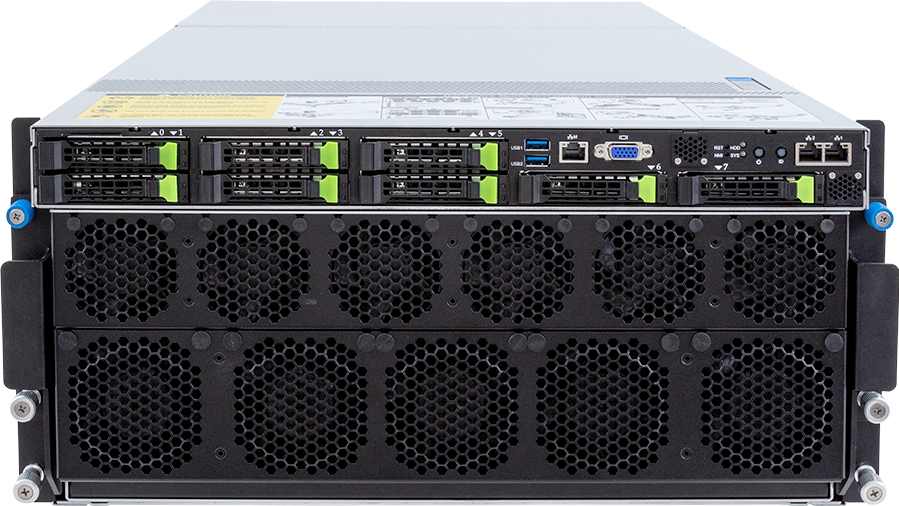
GIGABYTE G593-SD0 — front barebone 5U ze ścianą wentylatorów
G593 (HGX)
G593-SD0
ComputeEnterprise
Konfiguruj →
G593-SD0
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
GIGABYTE G593-SD1 — front barebone 5U ze ścianą wentylatorów
G593 (HGX)
G593-SD1
ComputeEnterprise
Konfiguruj →
G593-SD1
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
Supermicro
Platformy Supermicro 8U na płycie bazowej NVIDIA HGX.
8U HGX (SXM5)
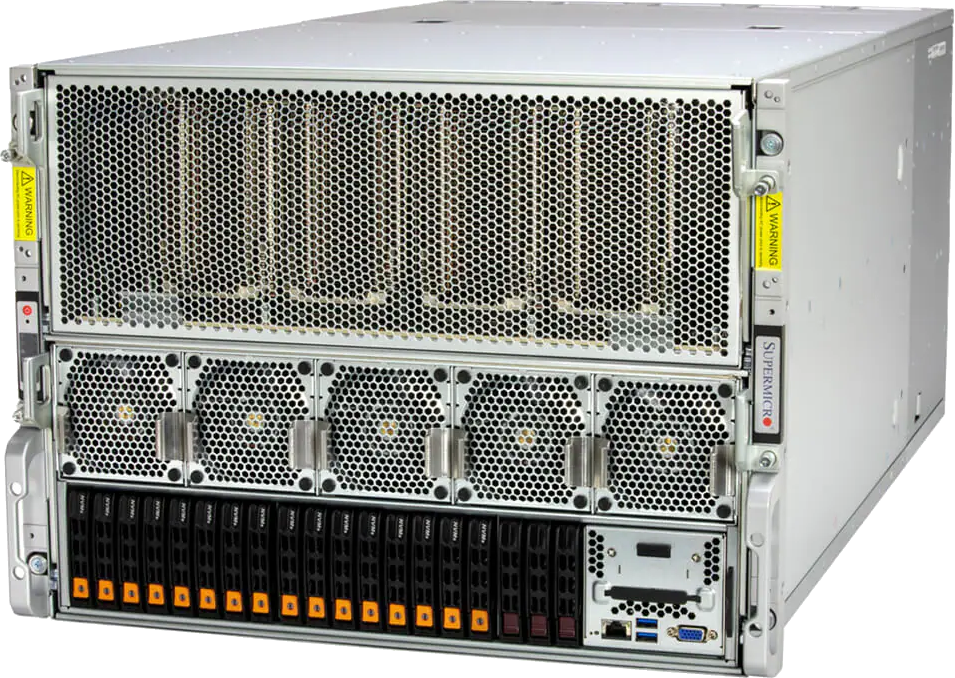
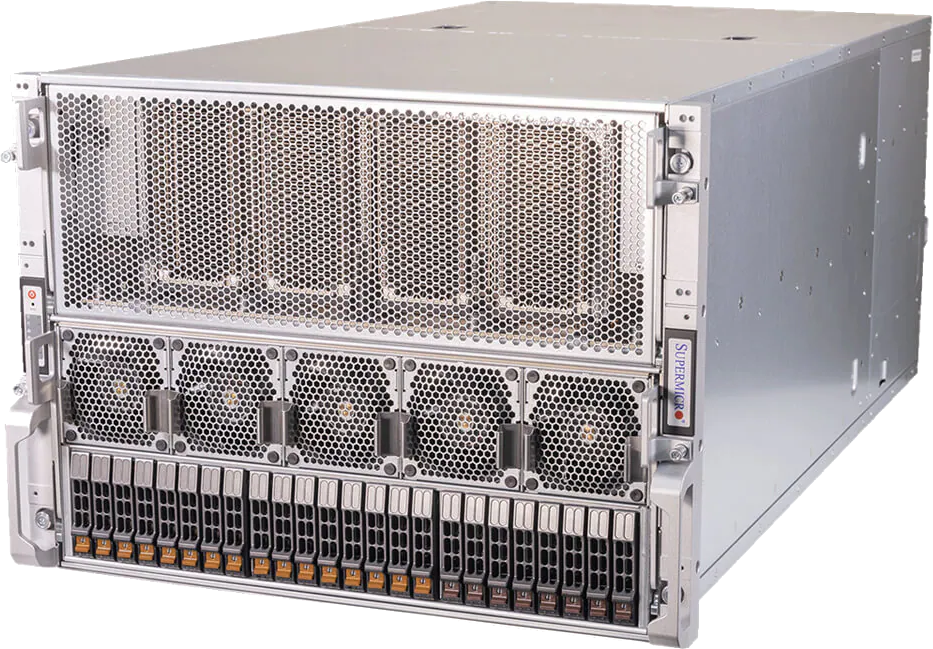
Supermicro SYS-821GE-TNHR — ujęcie 3/4 barebone 8U
8U HGX (SXM5)
SYS-821GE-TNHR
ComputeEnterprise
Konfiguruj →
SYS-821GE-TNHR
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację
Supermicro AS-8125GS-TNHR — ujęcie 3/4 barebone 8U
8U HGX (SXM5)
AS-8125GS-TNHR
ComputeEnterprise
Konfiguruj →
AS-8125GS-TNHR
Wysoka liczba rdzeni
Klasa enterprise
ECC
HPC / AI
Zobacz konfigurację

Karty GPU w tej kategorii: NVIDIA A100 80 GB, NVIDIA A100 SXM4, NVIDIA B200, NVIDIA B300, NVIDIA H100, NVIDIA H100 SXM5 80 GB, NVIDIA H200, NVIDIA H200 SXM5

Do czego to służy

Ta klasa maszyn powstaje dla zadań, których jedna karta nie udźwignie i których podział na osobne serwery kosztuje więcej niż daje. Trzy scenariusze są typowe.

  • Trening modeli dużej skali. Osiem układów pracuje jak jedna pula pamięci połączona NVLinkiem, więc model rozłożony na wszystkie karty wymienia gradienty bez wąskiego gardła magistrali płyty.
  • Modele przekraczające pojemność serwera PCIe. Węzeł B200 z 1440 GB pamięci GPU przyjmuje modele, których nie da się rozłożyć na osiem kart PCIe bez podziału między maszyny.
  • Blok konstrukcyjny klastra. Płyta HGX jest jednostką, z której NVIDIA składa konfiguracje BasePOD i SuperPOD, więc pojedynczy węzeł stanowi naturalny punkt startu dla większego środowiska.

Ten sam projekt płyty trafia do obudów kilku producentów. W katalogu stoją systemy ASUS ESC N8-E11, Gigabyte G593 oraz Supermicro SYS-821GE-TNHR, które różnią się topologią PCIe dla kart dodatkowych, układem zasilania i wysokością obudowy. Rdzeń obliczeniowy pozostaje ten sam, bo pochodzi z jednego projektu referencyjnego.

Porównanie i dobór

Różnica wobec działu serwerów GPU PCIe sprowadza się do sposobu połączenia kart. W obudowie PCIe każda karta rozmawia z resztą przez magistralę płyty głównej. W obudowie SXM układy łączy NVLink z przełącznicą NVSwitch, dająca do 900 GB/s pasma na kartę, dzięki czemu osiem GPU zachowuje się jak jeden akcelerator o wspólnej pamięci.

Wybór między działami wynika z kształtu zadania. Jeśli praca dzieli się na niezależne procesy, na przykład wiele modeli inferencyjnych albo kolejka renderu, serwer PCIe wykonuje ją taniej. Jeśli jedno obliczenie musi objąć całą pamięć ośmiu kart, sensowny jest węzeł SXM. Stacje robocze z pojedynczymi kartami stoją w dziale stacje robocze, a systemy Grace Blackwell z pamięcią koherentną w dziale AI Supercomputers.

Najczęstsze pytania

Czym serwer DGX różni się od serwera GPU PCIe?

Osadzeniem kart i połączeniem między nimi. Moduły SXM są zamontowane na wspólnej płycie HGX i połączone NVLinkiem, a karty PCIe wchodzą w gniazda płyty głównej. Dla jednego dużego obliczenia rozłożonego na osiem układów ta różnica przekłada się na czas wymiany danych.

Co to jest NVSwitch?

Przełącznica łącząca wszystkie układy GPU w węźle, dzięki której każda karta rozmawia z każdą inną pełnym pasmem NVLink, do 900 GB/s. Bez niej komunikacja przebiegałaby przez wolniejszą magistralę systemową.

Ile GPU pracuje w jednym węźle?

Osiem. Taka jest jednostka konstrukcyjna płyty HGX we wszystkich generacjach obecnych w katalogu, od A100 po B300.

Ile pamięci GPU ma węzeł poszczególnych generacji?

DGX A100 występuje w wariantach 320 i 640 GB, H100 ma 640 GB, H200 daje 1128 GB, B200 osiąga 1440 GB, a B300 zbliża się do 2,1 TB. Pamięć rośnie z każdą generacją szybciej niż liczba układów, która pozostaje stała.

Czy da się połączyć kilka węzłów?

Architektura HGX jest blokiem, z którego składa się konfiguracje NVIDIA BasePOD i SuperPOD. Środowisko wielowęzłowe wykracza poza cennik katalogowy i przechodzi przez indywidualną wycenę.

Jak wygląda dostępność i wycena w tym dziale?

Część pozycji ma opublikowaną ratę miesięczną, widoczną w tabeli powyżej. Pozostałe kompletujemy pod zamówienie, dlatego stawkę podajemy po ustaleniu konfiguracji i terminu.