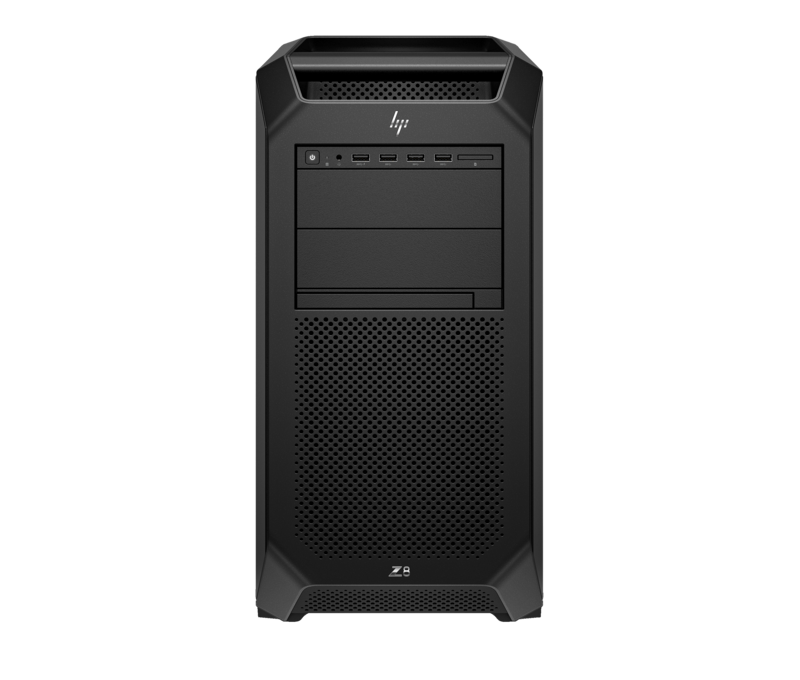
cała maszyna
HP Z4 G5 · TRDC-6000MQ-1

TR DC 6000MQ Solo
- Karty
- 1× RTX PRO 6000 Blackwell Max-Q 96 GB
- Rdzenie
- 24 fizyczne
- RAM
- 256 GB · 3,84 TB NVMe


6 000zł netto / mies.
Zobacz szczegóły 
 Blackwell
Wybrany okres: miesiąc — opłata 301 968 zł netto/mies. (371 421 zł brutto), bez zobowiązania — rezygnacja możliwa w dowolnym momencie. Opłata wdrożeniowa 3 900 zł netto (4 797 zł brutto) jednorazowo.
Zadzwoń lub napisz: ☎ +48 22 415 49 93 · [email protected]
Wycena indywidualna. Cenę potwierdzamy w ofercie przed zawarciem umowy.
Ceny netto, opłata miesięczna przy wybranym okresie. Maszyna pracuje w kolokacji w profesjonalnej serwerowni, pracuje pod zasilaniem awaryjnym i chłodzeniem, a Ty masz do niej pełny dostęp zdalny. W abonamencie: łącze 1 Gbit/s, transfer do 20 TB miesięcznie, adres IPv4, IPv6 /64, prywatny VLAN 10 Gbit/s, kopia zapasowa konfiguracji i wsparcie w godzinach roboczych. Abonament płatny z góry za okres rozliczeniowy, przelewem, termin 7 dni od faktury; naliczanie zaczyna się od uruchomienia maszyny i przekazania danych dostępowych. Najem miesięczny wypowiadasz z miesięcznym wyprzedzeniem, bez dodatkowych opłat. Przy okresie 6 lub 12 miesięcy wcześniejsza rezygnacja jest możliwa — rozliczamy wtedy udzielony rabat i część pozostałych okresów na zasadach z umowy. Opłata wdrożeniowa 3 900 zł netto (4 797 zł brutto) dotyczy wyłącznie najmu miesięcznego — przy najmie na 6 i 12 miesięcy nie pobieramy jej wcale.
NVIDIA DGX B200 na wynajem to pierwszy węzeł generacji Blackwell w naszym katalogu: osiem modułów B200 SXM po 180 GB daje 1 440 GB pamięci HBM3e o sumarycznej przepustowości 64 TB/s, spiętych dwoma przełącznikami NVLink piątej generacji o łącznej przepustowości 14,4 TB/s. Maszyna pracuje na dwóch procesorach Intel Xeon Platinum 8570, ma 2 TB pamięci systemowej rozszerzalnej do 4 TB i karty BlueField-3 po stronie danych. Obudowa urosła do 10U, a pobór do 14,3 kW. Uwaga do stawki: pozycja opiera się na jednym źródle zaopatrzenia dla sprzętu, którego ceny rynkowe wciąż się zmieniają — potwierdzamy ją przy wycenie.
Blackwell wprowadza czterobitowy format zmiennoprzecinkowy i drugą generację rdzeni Transformer Engine. Deklarowana wydajność sięga 144 petaFLOPS w FP4 z rzadkością i 72 petaFLOPS w FP8 — przy 1 440 GB pamięci daje to maszynę, na której mieszczą się modele wymagające dotąd dwóch węzłów Hoppera.
Karty BlueField-3 przejmują obsługę ruchu sieciowego i pamięci masowej z procesorów głównych, co przy treningu rozproszonym zdejmuje część narzutu z rdzeni Xeon.
Wobec DGX H200. Pamięć rośnie z 1 128 GB do 1 440 GB, dochodzi format FP4 i NVLink piątej generacji o przepustowości 14,4 TB/s. Rosną też wymagania: obudowa 10U zamiast 8U, 14,3 kW zamiast 10,2 kW i inny profil chłodzenia. Przy modelach, które mieszczą się w Hopperze i przy stosie zestrojonym pod FP8, przewaga Blackwella ujawnia się głównie w przepustowości inferencji. Zobacz DGX H200.
Wobec DGX H100 z poprzedniej generacji. Tu różnica jest już całkowita: 1 440 GB wobec 640 GB pamięci, NVLink o generację nowszy (14,4 TB/s wobec 7,2 TB/s w przełącznikach NVSwitch) i nowy format obliczeń. To skok przez pełną generację architektury, a nie wymiana modułów w tej samej konstrukcji. Zobacz kartę NVIDIA DGX H100.
Wobec DGX B300. Obie maszyny należą do rodziny Blackwell i zajmują 10U. B300 ma 2,1 TB pamięci, podwojoną sieć klastrową na kartach ConnectX-8 oraz wyższą gęstą wydajność FP4. B300 występuje w wariancie zasilania AC i w wariancie na szynie DC 54 V. Pobór obu maszyn jest podobny (ok. 14,3 kW wobec 14–14,5 kW), a B200 jest lżejszy: 142,4 kg wobec 168 kg w wariancie AC B300. Zobacz DGX B300.
Trzy rzeczy naraz: format FP4 z drugą generacją rdzeni Transformer Engine, przełączniki NVLink piątej generacji o przepustowości 14,4 TB/s oraz 180 GB pamięci na moduł zamiast 80 GB w H100. Zmienia się także budowa węzła — pojawiają się karty BlueField-3 po stronie danych, a obudowa i zapotrzebowanie na moc rosną.
W praktyce FP4 służy przede wszystkim inferencji i tym etapom treningu, w których niska precyzja nie psuje zbieżności. Trening prowadzi się zwykle w FP8 albo bf16, a mechanizm dobierający precyzję pilnuje warstw wrażliwych numerycznie. Deklarowane 144 petaFLOPS dotyczy FP4 z rzadkością, więc do porównań treningowych właściwszą liczbą jest 72 petaFLOPS w FP8.
Szczyt to około 14,3 kW przy sześciu zasilaczach 3,3 kW w układzie pięć plus jeden, a obudowa zajmuje 10U. To wartości, które w standardowej szafie kolokacyjnej wymagają osobnego przydziału mocy i sprawdzonego odbioru ciepła. Maszyna pracuje w kolokacji w profesjonalnej serwerowni przygotowanej pod tę klasę poboru, więc temat zasilania i chłodzenia zostaje po naszej stronie.
Sprzęt tej generacji ma wąską podaż, a jego ceny nie ustabilizowały się na rynku. Nasza stawka opiera się na jednym potwierdzonym źródle zaopatrzenia, czyli na pojedynczej ofercie zakupu, która może się zmienić wraz z podażą. Zamiast chować to zastrzeżenie, mówimy o nim wprost i potwierdzamy stawkę przy każdym zapytaniu.
B200 wystarcza wszędzie tam, gdzie 1 440 GB pamięci mieści zadanie, a instalacja ma być prosta. B300 ma sens przy modelach wymagających 2,1 TB pamięci, przy klastrach spinanych łączami 800 Gb/s oraz przy planach migracji na szafy MGX. Przy jednym węźle inferencyjnym różnica bywa nieodczuwalna.
Systemy DGX są zamkniętym kompletem NVIDII i nie mają konfiguratora — pamięć, procesory i dyski przychodzą w ustalonym zestawie. Pamięć systemowa jest fabrycznie rozszerzalna do 4 TB, ale sam skład maszyny pozostaje niezmienny. Konfigurowalne platformy tej klasy znajdziesz w części katalogu z płytami HGX.
Potrzebne są sterowniki i wersja biblioteki obliczeniowej obsługujące nową architekturę, a wykorzystanie FP4 wymaga bibliotek, które ten format znają. Kod napisany pod Hoppera zwykle uruchamia się bez przepisywania, natomiast pełną korzyść z nowych rdzeni daje dopiero aktualizacja stosu treningowego i silnika inferencyjnego.
Więcej o karcie: NVIDIA B200 — serwer Blackwell do treningu dużych modeli