cała maszyna
HP Z4 G5 · TRDC-6000MQ-1

TR DC 6000MQ Solo
- Karty
- 1× RTX PRO 6000 Blackwell Max-Q 96 GB
- Rdzenie
- 24 fizyczne
- RAM
- 256 GB · 3,84 TB NVMe


6 000zł netto / mies.
Zobacz szczegóły 
 Ampere
Wybrany okres: miesiąc — opłata 57 366 zł netto/mies. (70 560 zł brutto), bez zobowiązania — rezygnacja możliwa w dowolnym momencie. Opłata wdrożeniowa 3 900 zł netto (4 797 zł brutto) jednorazowo.
Zadzwoń lub napisz: ☎ +48 22 415 49 93 · [email protected]
Ceny netto, opłata miesięczna przy wybranym okresie. Maszyna pracuje w kolokacji w profesjonalnej serwerowni, pracuje pod zasilaniem awaryjnym i chłodzeniem, a Ty masz do niej pełny dostęp zdalny. W abonamencie: łącze 1 Gbit/s, transfer do 20 TB miesięcznie, adres IPv4, IPv6 /64, prywatny VLAN 10 Gbit/s, kopia zapasowa konfiguracji i wsparcie w godzinach roboczych. Abonament płatny z góry za okres rozliczeniowy, przelewem, termin 7 dni od faktury; naliczanie zaczyna się od uruchomienia maszyny i przekazania danych dostępowych. Najem miesięczny wypowiadasz z miesięcznym wyprzedzeniem, bez dodatkowych opłat. Przy okresie 6 lub 12 miesięcy wcześniejsza rezygnacja jest możliwa — rozliczamy wtedy udzielony rabat i część pozostałych okresów na zasadach z umowy. Opłata wdrożeniowa 3 900 zł netto (4 797 zł brutto) dotyczy wyłącznie najmu miesięcznego — przy najmie na 6 i 12 miesięcy nie pobieramy jej wcale.
| Dostawca i oferta | Zakres usługi | Cena u dostawcy | Po przeliczeniu na złote | Nasza cena | Różnica |
|---|---|---|---|---|---|
| Dostawca 1 — bare metal2 maszyny po 4× A100 80 GB, rozliczenie miesięczne | bare metal | 2 × 5 749 €/mies.rozlicza: miesiącdwie maszyny po 4x A100 80 GB (2 x 24 728 zł) zamiast jednej ośmiokartowej — między maszynami nie ma NVLinka | ≈ 49 456 złcena miesięczna z cennikanasze przeliczenie | 57 366 złmiesiąc | 7 910 złwycena indywidualna |
| Dostawca 1 — bare metal2 maszyny po 4× A100 80 GB, plan roczny | bare metal | 2 × 4 788 €/mies.rozlicza: rokta sama para maszyn w rozliczeniu rocznym (2 x 20 595 zł) | poza ofertąoferta dostępna od 12 miesięcy | 57 366 złmiesiąc | brak wspólnego okresu |
Różnica w cenie wynika z różnic w konfiguracji i zakresie usługi, opisanych przy każdej pozycji. Przy umowie rocznej, kolejnej maszynie lub dłuższej współpracy przygotujemy wycenę indywidualną.
Kolumna „Cena u dostawcy” to kwota, którą dostawca wystawia na fakturze — w swojej walucie i w swoim okresie rozliczeniowym. Ceny pochodzą z publicznych cenników dostawców (stan na 25.09.2026); kwoty dostawców i nasze podajemy bez VAT. W kolumnie „Różnica” porównujemy naszą cenę z ceną dostawcy w tym samym okresie najmu: „u nas taniej o” oznacza, że nasza cena jest niższa; kwota z dopiskiem „wycena indywidualna” oznacza, o ile nasza cena jest wyższa. To porównanie cen, a nie potwierdzenie identycznej konfiguracji CPU, RAM, dysku i GPU.
Kolumna „Po przeliczeniu na złote” to nasze przeliczenie po kursie średnim NBP 4,3013 zł za euro i 3,7330 zł za dolara (tabela 148/A/NBP/2026 z 03.08.2026). Nie jest to cena z cennika dostawcy.
Przy ofertach rozliczanych w euro lub dolarach kwota faktury w złotych zmienia się co miesiąc wraz z kursem waluty. Nasza cena jest stała w złotych, faktura VAT, bez przelicznika. Różnica w tabeli powyżej zmienia się razem z kursem. To, że otrzymują Państwo całą maszynę fizyczną, pozostaje bez zmian.
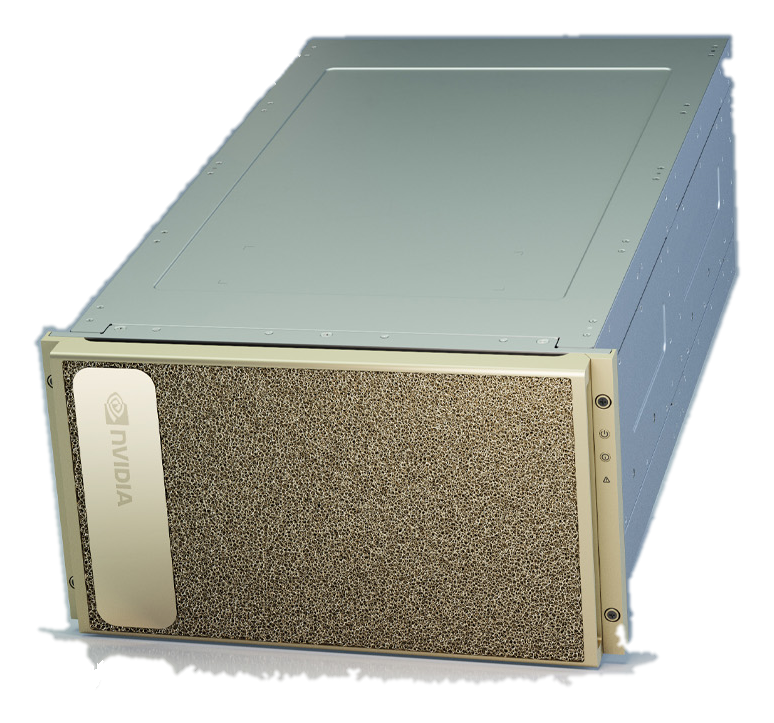
NVIDIA DGX A100 640 GB na wynajem to pełna wersja węzła Ampere: osiem modułów A100 SXM4 po 80 GB daje 640 GB pamięci GPU przy niezmienionej obudowie 6U i niezmienionym poborze 6,5 kW. Względem wariantu wejściowego podwojone są także pamięć systemowa (2 TB) i przestrzeń na dane (30 TB NVMe w RAID 0), a karty klastrowe mogą być z rodziny ConnectX-6 albo ConnectX-7. NVIDIA nie podnosi tu deklarowanej mocy obliczeniowej — korzyść opisuje jako przyspieszenie zadań treningowych dużej skali.
Podwojona pamięć na moduł przesuwa granicę tego, co da się zrobić bez dzielenia modelu na wiele maszyn. 80 GB na układ to najczęściej powtarzany próg w narzędziach treningowych z lat 2022–2024, więc większość gotowych przepisów i konfiguracji uruchamia się tu bez przerabiania.
30 TB przestrzeni NVMe w konfiguracji RAID 0 pozwala trzymać kompletny zbiór treningowy lokalnie, bez pobierania danych z zewnętrznej pamięci masowej w każdej epoce.
Wobec wariantu 320 GB. Identyczna konstrukcja, dwukrotnie większe zasoby: 80 GB zamiast 40 GB na moduł, 2 TB zamiast 1 TB pamięci systemowej, 30 TB zamiast 15 TB na dane. Dopłata ma sens wtedy, gdy model po podziale przekracza 40 GB na układ albo gdy zbiór treningowy przestaje mieścić się w lokalnej przestrzeni. Zobacz DGX A100 320 GB.
Wobec generacji Hopper: DGX H100. Hopper zmienia trzy rzeczy naraz: format FP8 z rdzeniami Transformer Engine, NVLink o przepustowości 900 GB/s na układ zamiast 600 GB/s (łącznie 7,2 TB/s w czterech przełącznikach NVSwitch) i procesory Intel Xeon Platinum zamiast pary EPYC. Pojemność pamięci GPU pozostaje na poziomie 640 GB, więc granica rozmiaru modelu jest ta sama — zmienia się tempo pracy i sposób, w jaki liczone są macierze. Sprawdź DGX H100.
Wobec serwera PCIe z ośmioma kartami A100 80 GB. Suma pamięci wychodzi identyczna, różni się topologia. Moduły SXM4 na wspólnej płycie komunikują się przez NVSwitch, karty PCIe — przez magistralę systemową. Przy treningu z podziałem tensorów odbija się to na czasie kroku; przy zadaniach, w których każdy proces pracuje na własnej karcie, różnica praktycznie znika, a maszyna PCIe daje swobodę w doborze procesorów i pamięci.
Wtedy, gdy pojedynczy moduł przestaje wystarczać: model po podziale przekracza 40 GB na układ, sekwencje treningowe są długie, wsad wymaga dużych aktywacji albo zbiór danych nie mieści się w 15 TB. Jeżeli żaden z tych warunków nie zachodzi, wariant wejściowy wykonuje tę samą pracę taniej.
Do inferencji i dostrajania — tak, z zapasem: wagi modelu 70B w bf16 to około 140 GB, więc rozkładają się na dwa do czterech modułów, a pozostałe zostają na kontekst i równoległe żądania. Do treningu od zera modeli tej wielkości potrzebny jest klaster wielu węzłów, a nie pojedyncza maszyna.
Tak, i to bez sztuczek programowych. Układy A100 obsługują sprzętowy podział na oddzielne instancje z własną pamięcią i własnymi jednostkami obliczeniowymi. Maszyna pozostaje w całości u jednego najemcy, a to on decyduje, jak rozdzielić ją między swoje projekty.
Zbiór treningowy leży przy procesorach i układach graficznych, więc każda epoka czyta go z dysku lokalnego zamiast z sieci. Przy zbiorach obrazowych i wideo liczonych w terabajtach to zwykle różnica między pełnym obciążeniem układów a czekaniem na dane. Przestrzeń pracuje w RAID 0, czyli jako pamięć podręczna na dane robocze, a nie jako magazyn archiwalny.
Konstrukcja to przewiduje: maszyna ma do dziesięciu portów kart sieciowych z rodziny ConnectX, w tym łącza InfiniBand 200 Gb/s przeznaczone do spinania węzłów. Sposób połączenia i wymaganą sieć ustalamy przy wycenie, bo zależą od liczby węzłów i planowanej topologii.
Rozliczamy najem miesięczny oraz umowy sześcio- i dwunastomiesięczne; przy dłuższym okresie opłata miesięczna jest niższa. Opłatę wdrożeniową pobieramy wyłącznie w najmie miesięcznym — przy dłuższych okresach nie występuje. Ceny podajemy netto, płatne z góry za okres rozliczeniowy.
Nie ma takiej możliwości — DGX A100 to zamknięty komplet fabryczny NVIDII, w którym procesory, pamięć i układ dysków są ustalone przez producenta. Zmiana rozmiaru pamięci systemowej albo procesorów oznacza wybór platformy partnerskiej z płytą HGX. Zobacz platformę Supermicro SYS-821GE-TNHR.
Więcej o karcie: NVIDIA A100 SXM4 — serwer klasy DGX z NVLink. Porównanie rodziny: Serwer z kartą NVIDIA A100 80 GB — wynajem miesięczny