cała maszyna
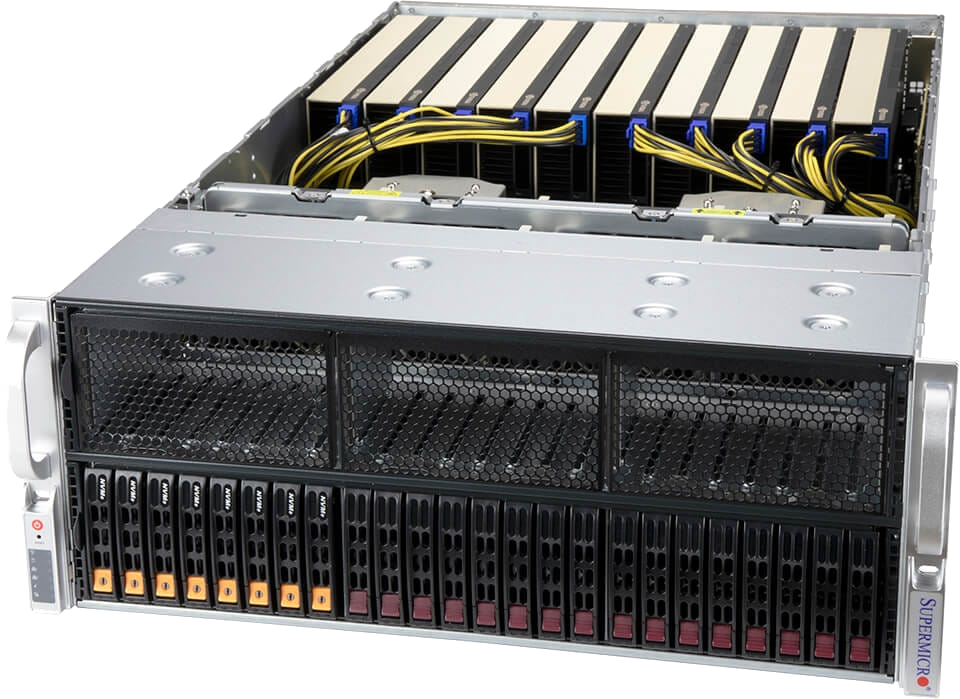
Supermicro SYS-420GP-TNR · TRDC-RACK-A100-2

TR DC Rack A100 2
- Karty
- 2× A100 80 GB
- Rdzenie
- 64 fizyczne
- RAM
- 512 GB · 0,50 TB NVMe
termin w ofercie


11 600zł netto / mies.
Zobacz szczegóły Wynajmujesz całą maszynę z kartami lub modułami NVIDIA A100 na wyłączność, razem z procesorami, pamięcią i dyskami, a nie wirtualny wycinek karty ani wirtualne rdzenie na serwerze dzielonym z innymi klientami. Wynajem NVIDIA A100 obejmuje serwery rackowe z dwiema, czterema albo ośmioma kartami A100 80 GB oraz fabryczne węzły NVIDIA DGX A100. NVIDIA A100 80 GB to układ Ampere z pamięcią HBM2e o przepustowości około 2 TB/s i obsługą MIG, czyli sprzętowego podziału jednej karty na maksymalnie siedem odizolowanych instancji. W ofercie mamy siedem konfiguracji rackowych z tą kartą: od dwóch układów i 160 GB pamięci graficznej po osiem układów i 640 GB. Opłata jest stała — od 9 628 zł netto miesięcznie (11 842 zł brutto), czyli 6,59 zł za godzinę pracy jednej karty w przeliczeniu, bez licznika, z transferem wychodzącym do 20 TB miesięcznie w cenie.
Przeglądaj katalog →
80 GB HBM2e na kartę wyznacza granicę tego, co zmieści się bez dzielenia modelu między maszyny. Model 70B w kwantyzacji ośmiobitowej to około 70 GB wag — mieści się na jednym układzie razem z krótkim kontekstem. Ten sam model w BF16 zajmuje około 140 GB, więc pracuje dopiero na parze kart i 160 GB pamięci.
Cztery karty i 320 GB pamięci to typowy węzeł do dostrajania modeli klasy 70B metodą LoRA oraz do inferencji wsadowej kilku modeli naraz. Osiem kart i 640 GB obsługuje pełne dostrajanie modeli klasy 30B, obliczenia HPC w podwójnej precyzji i farmy inferencyjne, w których każdy proces dostaje własny układ.
A100 obsługuje MIG: jeden układ dzieli się na maksymalnie siedem instancji ze sprzętowo rozdzieloną pamięcią i pamięcią podręczną. To rozwiązanie dla zespołu, który na jednej maszynie prowadzi kilkanaście lekkich zadań o przewidywalnym budżecie pamięci, zamiast jednego dużego treningu.
A100 należy do generacji Ampere. Względem nowszych układów różnica dotyczy pamięci i formatów obliczeń: A100 80 GB ma HBM2e o przepustowości około 2 TB/s, H100 — 80 GB HBM3 i 3,35 TB/s, a H200 — 141 GB HBM3e i 4,8 TB/s. Hopper dokłada Transformer Engine z natywnym FP8, którego Ampere nie zna, więc obliczenia opisane w FP8 uruchamia się tu w INT8 albo BF16.
Praktyczny podział wygląda tak: A100 wybiera się do zadań mieszczących się w 80 GB na układ i niezależnych od FP8, H100 do treningu z Transformer Engine, a H200 tam, gdzie decyduje pojemność pamięci na jeden układ. Po stronie łącza międzykartowego PCIe 4.0 x16 daje 32 GB/s w jedną stronę, a moduł A100 SXM4 — 600 GB/s przez NVLink.
Druga oś porównania to sposób sprzedaży mocy. Na rynku spotyka się rozliczanie wydzielonej części karty w stawce godzinowej. U nas jednostką najmu jest cała fizyczna maszyna z pełnym VRAM i stałą opłatą miesięczną, więc rachunek pozostaje ten sam niezależnie od liczby przepracowanych godzin.
A100 PCIe 80 GB pozostaje najlepiej opisanym sprzętem treningowym w ekosystemie CUDA i to on stoi za większością gotowych receptur uczenia w bibliotekach. W tej rodzinie obsadzamy dwie, cztery albo osiem kart, z pamięcią systemową od 512 GB do 2 TB i procesorami od 64 do 128 rdzeni fizycznych. Liczba konfiguracji w tej rodzinie: 7. Opłata miesięczna za całą maszynę zaczyna się od 9 628 zł netto (11 842 zł brutto) i sięga 38 512 zł netto (47 370 zł brutto) w wariancie najwyższym.
Ta rodzina powstała pod uczenie maszynowe i obliczenia naukowe. 80 GB pamięci HBM2e na kartę i przepustowość bliska 2 TB/s ustawiają A100 tam, gdzie zadanie ogranicza dostęp do pamięci, a nie liczba operacji zmiennoprzecinkowych.
Pamięć systemowa i liczba rdzeni są w tej rodzinie osobną osią wyboru. Wariant ze 128 rdzeniami fizycznymi obsługuje potoki z ciężkim wstępnym przetwarzaniem, gdzie procesor jest wąskim gardłem karmienia kart. Wariant z 2 TB pamięci pozwala też przenieść stany optymalizatora poza kartę przy technikach odciążania pamięci. Opis samej karty prowadzimy na stronie NVIDIA A100.
W obrębie katalogu A100 stoi między dwiema rodzinami. H200 NVL daje 141 GB pamięci HBM3e na kartę i jest wyborem tam, gdzie o wszystkim decyduje pojemność pamięci pod jeden model. RTX PRO 6000 Blackwell daje 96 GB pamięci GDDR7 i nowszą generację rdzeni, przy słabszej wydajności w podwójnej precyzji. A100 zostaje tam, gdzie liczy się dojrzałość stosu programowego i FP64.
Nasza opłata za całą maszynę mieści się między 9 628 zł netto (11 842 zł brutto) a 38 512 zł netto miesięcznie (47 370 zł brutto) i nie zależy od liczby przepracowanych godzin; w abonamencie mieści się transfer wychodzący do 20 TB miesięcznie.
Formą montażu i łączem między kartami. Karta PCIe wpina się w standardowy kadłub rackowy i komunikuje się przez PCIe 4.0 x16, czyli 32 GB/s w jedną stronę; moduł SXM4 przykręcany jest do płyty bazowej i wymienia dane przez NVLink z przepustowością 600 GB/s. Wersja PCIe pozwala też zamówić dokładnie tyle kart, ile potrzeba — od dwóch do ośmiu. Pełna specyfikacja wersji modułowej: A100 SXM4.
Przy kwantyzacji ośmiobitowej wagi zajmują około 70 GB i mieszczą się na jednym układzie, ale bez zapasu na długi kontekst. W BF16 model zajmuje około 140 GB, więc realnym minimum jest para kart (160 GB), a do dostrajania z optymalizatorem i cache kontekstu — cztery karty i 320 GB. Pamięć potrzebną dla modeli innej wielkości i precyzji liczy poradnik ile VRAM potrzebuje LLM.
Nie. MIG dzieli układ wewnątrz jednej wynajętej maszyny i to najemca decyduje, ile instancji utworzyć i komu je udostępnić. Cała maszyna wraz z kartami pozostaje przypisana do jednej umowy przez cały okres najmu.
Siedem. Różnią się liczbą kart (dwie, cztery albo osiem), pamięcią systemową (od 512 GB do 2 TB), pojemnością NVMe (od 0,5 TB do 8 TB) oraz liczbą rdzeni fizycznych procesorów (64, 96 albo 128). Pamięć graficzna wynika z liczby kart: 160, 320 albo 640 GB. Zestawienie wszystkich wariantów wraz ze stawkami zawiera tabela powyżej.
Tak, to zmiana maszyny na inną pozycję katalogu, a nie dokładanie kart do pracującego serwera — konfiguracje ośmiokartowe stoją na innych kadłubach niż czterokartowe. Nową opłatę i termin przeniesienia potwierdzamy w aneksie do umowy.
Termin uruchomienia potwierdzamy w ofercie razem z ceną. Na etapie wyceny podajemy datę, od której maszyna jest gotowa do przekazania dostępu.
Przygotowanie maszyny do pracy najemcy: montaż w szafie, konfigurację systemu i dostępu zdalnego oraz testy przed przekazaniem. Jej wysokość zależy od konfiguracji i jest podana przy każdej pozycji w tabeli cen. Przy serwerach rackowych z kartami A100 PCIe pobieramy ją przy najmie na 1 i 6 miesięcy, a przy węzłach NVIDIA DGX A100 tylko przy najmie na 1 miesiąc; przy umowie na 12 miesięcy jej nie ma.
A100 to układ obliczeniowy bez rdzeni RT i bez wyjść wideo, więc silniki renderujące korzystające ze sprzętowego ray tracingu nie wykorzystają jego mocnych stron. Do renderingu i pracy z obrazem lepiej dobrać L40S, a A100 zostawić do trenowania i inferencji.
Pod dwie rzeczy: potoki danych, w których dekodowanie i augmentacja dzieją się na procesorze, oraz techniki odciążania, które przenoszą stany optymalizatora i część wag poza kartę. Przy modelach, które nie mieszczą się w pamięci kart, to pamięć systemowa decyduje, czy trening w ogóle ruszy.
Wyłącznie przepustowością strony procesorowej. Przy klasycznym treningu obrazowym z ciężką augmentacją i przy potokach ładujących dane z dysku 128 rdzeni fizycznych utrzymuje karty w pracy; przy modelach językowych czytających gotowe tokeny różnica jest niewielka.
To warianty PCIe bez mostka, więc komunikacja między kartami idzie przez przełącznik PCIe. Trening równoległy po danych działa na tym układzie normalnie; przy podziale jednego modelu na wiele kart magistrala staje się czynnikiem ograniczającym.
Tam, gdzie liczy się przewidywalność stosu programowego i podwójna precyzja. A100 ma najlepiej przetestowane ścieżki w bibliotekach uczenia maszynowego, przepustowość pamięci bliską 2 TB/s i pełnoprawne FP64, którego karty graficzne nowszych generacji nie oferują w tej klasie.
Porównanie wszystkich kart: Karty GPU NVIDIA na wynajem — porównanie pamięci i cen

