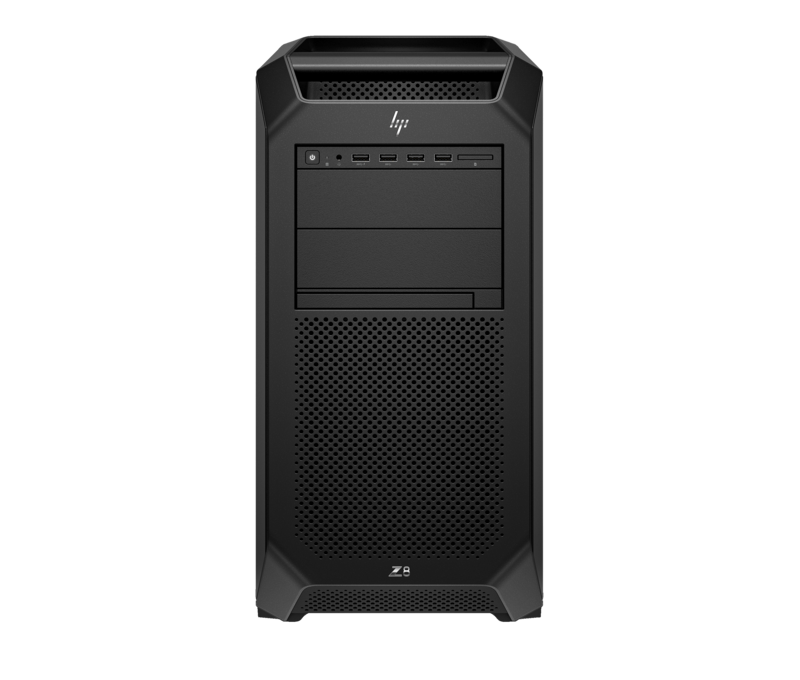
cała maszyna
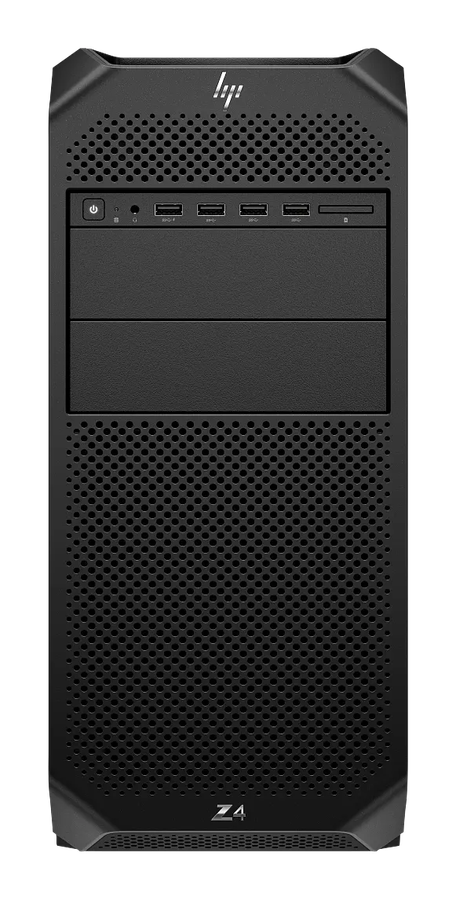
HP Z4 G5 · TRDC-6000MQ-1

TR DC 6000MQ Solo
- Karty
- 1× RTX PRO 6000 Blackwell Max-Q 96 GB
- Rdzenie
- 24 fizyczne
- RAM
- 256 GB · 3,84 TB NVMe


6 000zł netto / mies.
Zobacz szczegóły 
 Grace Blackwell
Wybrany okres: miesiąc — opłata 37 800 zł netto/mies., bez zobowiązania — rezygnujesz kiedy chcesz. Opłata wdrożeniowa 3 900 zł jednorazowo.
Ceny netto, opłata miesięczna przy wybranym okresie. Maszyna stoi w naszej serwerowni, pracuje pod zasilaniem awaryjnym i chłodzeniem, a dostęp jest zdalny. W abonamencie: łącze 1 Gbit/s, transfer do 20 TB miesięcznie, adres IPv4, IPv6 /64, prywatny VLAN 10 Gbit/s, kopia zapasowa konfiguracji i wsparcie w godzinach roboczych. Abonament płatny z góry za okres rozliczeniowy, przelewem, termin 7 dni od faktury; naliczanie zaczyna się od wydania maszyny. Najem miesięczny wypowiadasz z miesięcznym wyprzedzeniem, bez dodatkowych opłat. Przy okresie 6 lub 12 miesięcy wcześniejsza rezygnacja jest możliwa — rozliczamy wtedy udzielony rabat i część pozostałych okresów na zasadach z umowy. Opłata wdrożeniowa 3 900 zł netto dotyczy wyłącznie najmu miesięcznego — przy pakiecie od 3 miesięcy nie pobieramy jej wcale.
Domena NVLink obejmująca 72 układy zmienia sposób pisania kodu treningowego: model, którego wagi nie mieszczą się w jednym węźle, nie musi być dzielony na fragmenty komunikujące się przez sieć klastrową, bo cała szafa udostępnia spójną przestrzeń pamięci. To scenariusz dla modeli fundamentowych oraz dla inferencji rozumującej, w której długość łańcucha tokenów decyduje o opóźnieniu odpowiedzi.
Więcej o karcie: NVIDIA GB300 NVL72 — wynajem infrastruktury rack-scale AI