Wynajem całych stacji roboczych. Jeden klient dostaje jedną fizyczną maszynę na wyłączność: procesor, pamięć, dyski i karty znajdują się w tej samej obudowie. Rdzenie są fizyczne, karta jest cała, dyski są lokalne. Konsola KVM-over-IP, port 1 Gbit/s i pierwszy adres IPv4 są w cenie abonamentu. Sprzęt pracuje w kolokacji w profesjonalnej serwerowni na terenie Unii Europejskiej, a Ty masz do niego pełny dostęp zdalny. Lokalizację serwerowni dobieramy do Twoich potrzeb, także pod kątem dogodnego dostępu.
Wszystkie ceny netto. Kwota w kaflu to opłata miesięczna przy zobowiązaniu na miesiąc (bez zobowiązania) — nie kwota za cały okres. Abonament płatny z góry za okres rozliczeniowy, przelewem, termin 7 dni od faktury; naliczanie zaczyna się od uruchomienia maszyny i przekazania danych dostępowych. Najem miesięczny wypowiadasz z miesięcznym wyprzedzeniem, bez dodatkowych opłat. Przy okresie 6 lub 12 miesięcy wcześniejsza rezygnacja jest możliwa — rozliczamy wtedy udzielony rabat i część pozostałych okresów na zasadach z umowy. Przy najmie na 1 i 6 miesięcy do abonamentu dochodzi jednorazowa opłata wdrożeniowa podana przy każdej pozycji (w maszynach DGX i AI Supercomputers tylko przy 1 miesiącu); przy umowie na 12 miesięcy jej nie ma.
HP Z4 G5 10 stacji
Jednoprocesorowa stacja o najkrótszej ścieżce pamięć–karta. 24 rdzenie fizyczne, trzy sloty x16, maksymalnie dwie karty dwuslotowe (według dokumentacji producenta).
Port publiczny 1 Gbit/s, transfer wychodzący do 20 TB/mies. w cenie
Zdalny, z pełnymi uprawnieniami administratora w systemie; konsola KVM over IP w cenie, zmiany BIOS/UEFI na zlecenie
1× IPv4 + IPv6 /64 w cenie, VLAN prywatny 10 Gbit/s w cenie
Wdrożenie 1 500 zł jednorazowo
Zobacz konfigurację→
2 600zł netto / mies.
Zobacz szczegóły →
HP Z8 Fury G5 5 stacji
Osiem slotów PCIe i cztery karty w konfiguracjach dopuszczonych przez producenta. Fabryczny zasilacz 1450 W zapewnia 900 W dla kart; konfiguracje czterech kart 300 W wymagają trybu 2250 W aggregate.
Port publiczny 1 Gbit/s, transfer wychodzący do 20 TB/mies. w cenie
Zdalny, z pełnymi uprawnieniami administratora w systemie; konsola KVM over IP w cenie, zmiany BIOS/UEFI na zlecenie
1× IPv4 + IPv6 /64 w cenie, VLAN prywatny 10 Gbit/s w cenie
Wdrożenie 2 500 zł jednorazowo
Zobacz konfigurację→
6 400zł netto / mies.
Zobacz szczegóły →
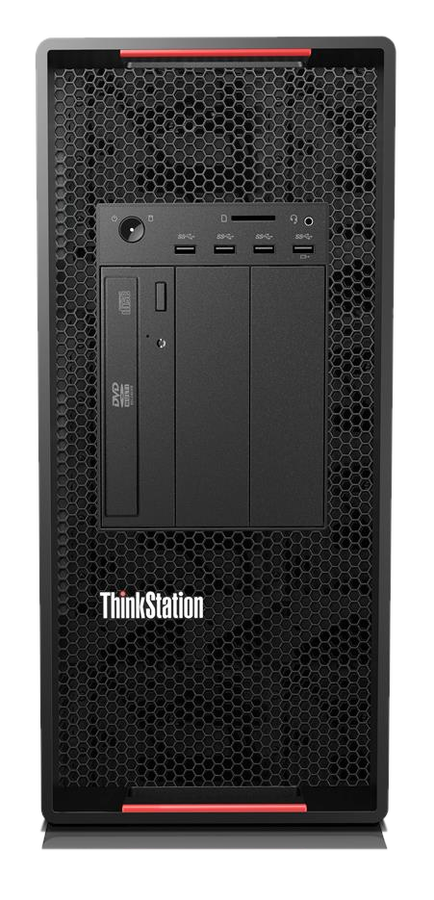
Lenovo ThinkStation PX 13 stacji
Dwuprocesorowa platforma szesnastogniazdowa — jedyna w tym dziale, która mieści osiem kart jednoslotowych albo cztery dwuslotowe i pozwala rozbudować RAM do 512 GB bez przechodzenia na 2 DPC.
Port publiczny 1 Gbit/s, transfer wychodzący do 20 TB/mies. w cenie
Zdalny, z pełnymi uprawnieniami administratora w systemie; konsola KVM over IP w cenie, zmiany BIOS/UEFI na zlecenie
1× IPv4 + IPv6 /64 w cenie, VLAN prywatny 10 Gbit/s w cenie
Wdrożenie 3 500 zł jednorazowo
Zobacz konfigurację→
17 400zł netto / mies.
Zobacz szczegóły →
Lenovo ThinkStation P8 4 stacje
Jednoprocesorowa platforma Threadripper PRO: 128 linii PCIe 5.0, siedem slotów, cztery gniazda x16 (sloty 1/3/5/6). Karty jednoslotowe RTX PRO 4000 od jednej do czterech; z kartami 300 W maksymalnie trzy (według dokumentacji producenta).
Port publiczny 1 Gbit/s, transfer wychodzący do 20 TB/mies. w cenie
Zdalny, z pełnymi uprawnieniami administratora w systemie; konsola KVM over IP w cenie, zmiany BIOS/UEFI na zlecenie
1× IPv4 + IPv6 /64 w cenie, VLAN prywatny 10 Gbit/s w cenie
Wdrożenie 2 500 zł jednorazowo
Zobacz konfigurację→
7 350zł netto / mies.
Zobacz szczegóły →
Stan stacji — wybierz wariant
Zapytaj o wycenę
Dziękujemy, zapytanie zostało wysłane
Dane z formularza wykorzystujemy wyłącznie do odpowiedzi na zapytanie i przygotowania oferty. Polityka prywatności
Otwieramy Twój program pocztowy
Jeśli się nie otworzył, skopiuj treść poniżej i wyślij ją na [email protected]. Odpowiadamy w 24 h w dni robocze.
Bare metal
Prawdziwy bare metal, nie chmura
Cała fizyczna maszyna z kartami GPU na wyłączność i pełne prawa administratora. Nie wirtualne rdzenie ani maszyna wirtualna.
NVIDIA GB10 · 128 GB pamięci zunifikowanej
Wynajmij DGX Spark lub inną maszynę z GB10
Superchip NVIDIA GB10 Grace Blackwell, 128 GB pamięci zunifikowanej — wspólnej dla procesora i GPU — oraz system NVIDIA DGX OS. Do wyboru oryginał NVIDIA albo wersja ASUS, Dell, HP, Gigabyte, MSI lub Acer. Maszyna pracuje w serwerowni, a Ty łączysz się zdalnie.Superchip NVIDIA GB10 i 128 GB pamięci zunifikowanej. Oryginał NVIDIA albo wersja ASUS, Dell, HP, Gigabyte, MSI lub Acer — z dostępem zdalnym.
Analizer zestawia oferty obok siebie i podpowiada, która maszyna pasuje do Twojej pracy. Cały serwer na wyłączność w profesjonalnej serwerowni, ze stałym dostępem zdalnym dla całej organizacji.
Przenieś obciążenia na wynajęte maszyny fizyczne w profesjonalnej serwerowni — także pod własną chmurę prywatną, którą na nich zbudujesz. Ten sam komfort pracy, mniejszy rachunek i pełna kontrola nad maszyną.
Nauka i uczelnie
Maszyna dobrana do Twojego oprogramowania
ANSYS, GROMACS, ORCA, VASP, LAMMPS. Wybierz oprogramowanie, a my wskażemy konfigurację, na której policzy się najszybciej. Parametry pokażemy na drugim kroku.
START CDC
Wynajmujesz całą fizyczną maszynę w kolokacji w profesjonalnej serwerowni — z pełnym dostępem zdalnym. Sprzęt dedykowany, infrastruktura w Unii Europejskiej.
1 : 1
jeden najemca na jedną maszynę
Rdzenie są fizyczne, karta jest cała, maszyna ma jednego najemcę. Klient, który potrzebuje czterech kart zamiast ośmiu, otrzymuje maszynę w konfiguracji z czterema kartami.
SLA
dostępność według umowy najmu
Poziom dostępności i bonifikaty za przerwy określa umowa najmu, którą otrzymujesz przed zamówieniem.
1 · 6 · 12
miesięcy — trzy okresy umowy
Opłata zależy od okresu, dlatego podajemy ją zawsze razem z okresem, przy konkretnej maszynie w katalogu.
01 · Fakty
Cztery kryteria, które rozstrzygają o zakupie
Klient tej branży kupuje dowodami, nie hasłami. Każdy z czterech punktów da się sprawdzić jedną komendą albo jednym dokumentem.
Cała maszyna fizycznaWynajmujesz płytę, procesory, pamięć i karty w jednej obudowie. Masz pełne uprawnienia administratora w systemie i zdalną konsolę KVM od chwili uruchomienia maszyny — możesz zainstalować własny system, zbudować własne jądro i dostroić je pod obciążenie. Zmiany w BIOS/UEFI, np. wyłączenie SMT, wykonujemy na Twoje zlecenie.test rozstrzygający: lscpu | grep -i hypervisor nie zwraca nicJeden najemcaKarta jest cała: pełny VRAM, pełne x16, bez vGPU, bez MIG, bez time-slicingu. Nie ma hypervisora, który mógłby przydzielać czas procesora innym maszynom.steal time %st = 0 z założeniaŁącze i transferW abonamencie port publiczny 1 Gbit/s, jeden publiczny adres IPv4 i pula IPv6 /64. Gwarantowany port 10 Gbit/s to opcja rozszerzenia. Prywatny VLAN 10 Gbit/s spinający kilka Twoich maszyn jest w cenie — szybszy wariant zamawiasz opcjonalnie.prywatny VLAN 10 Gbit/s w cenieDane w Unii EuropejskiejInfrastruktura i dane pozostają w Unii Europejskiej, bez transferu poza Europejski Obszar Gospodarczy. Faktury w systemie KSeF, opłata w złotych. W komplecie dokumentów umowa powierzenia przetwarzania danych (art. 28 RODO).bez przelicznika walutowego
02 · Wejście
Trzy drogi wejścia w ofertę
Nie każdy zaczyna od specyfikacji. Trzy ścieżki prowadzą do tego samego katalogu, ale z trzech różnych pytań.
To nie jest porównywarka cen. To tłumacz z języka cenników na język sprzętu.
Jaką część karty otrzymujesz — całą, połowę, ćwiartkę czy jedną szóstą — i czy współdzielisz ją z innymi użytkownikami przez vGPU, MIG albo time-slicing.
Ile rdzeni fizycznych obejmuje oferta: 36 vCPU przy włączonym SMT to 18 rdzeni fizycznych, a ta sama etykieta znaczy u jednego dostawcy dwie różne rzeczy.
Czy to cała maszyna: bare metal z IPMI, maszyna wirtualna, kontener czy węzeł Kubernetesa — i gdzie fizycznie stoi.
Różnica wobec naszej oferty podana w złotych, przy tym samym okresie umowy.
Konsola KVM od chwili uruchomienia; zmiany BIOS/UEFI na zlecenie
Brak
Brak
Brak
Dysk
NVMe w tej samej obudowie
Zwykle wolumen sieciowy
Wolumen sieciowy
Wolumen sieciowy
Sąsiedzi na maszynie
Brak — jeden najemca
Są
Są
Są
Maszyna wirtualna z kartą przekazaną przez PCI passthrough to nadal maszyna wirtualna. Nie nazywamy jej bare metalem. Twierdzenia w tabeli mają pokrycie w dokumentacji technicznej QEMU, NVIDIA (vGPU i MIG) oraz dostawców chmury publicznej.
04 · Katalog
Pięć działów, jeden model — wynajem całych maszyn
Wynajmujemy całe zestawy, nigdy części — każdy pracuje w profesjonalnej serwerowni i jest dostępny zdalnie. Każdy rodzaj maszyn ma w katalogu osobny dział.
Wynajęta maszyna pracuje w kolokacji w profesjonalnej serwerowni, a Ty korzystasz z niej zdalnie. Parametry obiektu określają, jaki sprzęt można zainstalować w szafie, i stanowią podstawę zobowiązania dostępności.
Zasilanie
Obiekt kolokacyjny z zasilaniem gwarantowanym i agregatem. Łańcuch zasilania jest zwymiarowany do zobowiązania dostępności.
Chłodzenie
Powietrzne, z zabudową korytarza zimnego, dobrane do gęstości mocy w szafie. O liczbie maszyn w szafie decyduje moc w kilowatach, a nie liczba jednostek U.
Łącze i transfer
Port publiczny 2,5 Gbit/s gwarantowany przy serwerach GPU i 1 Gbit/s przy stacjach roboczych. Gwarantowany port 10 Gbit/s jest opcją rozszerzenia.
VLAN i segmentacja
Trzy rozłączne domeny: VLAN klienta, VLAN zarządzania (BMC, KVM, PDU) i VLAN infrastruktury. Do sieci zarządzania nie ma trasy z sieci klienta. Połączenie z konsolą przechodzi przez pośrednika w panelu — nigdy bezpośrednio do urządzenia.
Kopia konfiguracji
Konfiguracje infrastruktury i przełączników przechowujemy w repozytorium z pełną historią zmian, a wzorcowe obrazy systemów — w trzech ostatnich wersjach.
Między najmami
Secure erase nośników NVMe, reset BIOS i BMC do szablonu, rotacja haseł dostępu serwisowego, usunięcie VLAN-u. Po zakończeniu tych czynności otrzymujesz protokół sanityzacji.
Zakres kopii zapasowej: dane, które umieścisz na wynajętej maszynie, nie są objęte naszą kopią zapasową. Kopia zapasowa jest odrębnie płatną pozycją cennika i wymaga umowy powierzenia przetwarzania danych. Bez umowy powierzenia nie możemy kopiować Twoich danych.
06 · Umowa
Warunki, które da się przeczytać przed zamówieniem
Oferta wyłącznie dla firm — nie zawieramy umów z konsumentami. Warunki podajemy w całości przed zamówieniem; szczegóły w umowie najmu.
Faktura i walutaFaktura VAT w złotych, wystawiana jako faktura ustrukturyzowana w KSeF. Stawka nie zmienia się z kursem waluty, bo nie ma w niej przelicznika walutowego.płatność przelewem, termin 7 dniPoczątek naliczaniaNaliczanie okresu rozpoczyna się dopiero od uruchomienia maszyny w serwerowni i przekazania danych dostępowych — nie w chwili przelewu.okres liczony od przekazania dostępuZakończenie umowyUmowa miesięczna: jednomiesięczne wypowiedzenie ze skutkiem na koniec okresu rozliczeniowego, bez dodatkowej opłaty. Umowa na 6 albo 12 miesięcy: przy wcześniejszym zakończeniu rozliczamy udzielony rabat i część pozostałych okresów.wypowiedzenie miesięczne bez dodatkowej opłatySLA i dane osoboweDostępność i bonifikaty za przerwy określa umowa najmu, którą otrzymujesz przed zamówieniem. Do umowy dołączamy umowę powierzenia przetwarzania i rejestr podprocesorów.umowa powierzenia i rejestr podprocesorów w komplecie
07 · Migracja
Zmiana dostawcy chmury — fakty i mity
Poniżej zestawiamy, co wynika z przepisów Unii Europejskiej, a co nie.
Żaden przepis nie nakazuje rezygnacji z chmur spoza Unii Europejskiej
W prawie Unii nie istnieje ani dyrektywa, ani rozporządzenie nakazujące firmom migrację do dostawców europejskich. Istnieje natomiast coś istotnego dla Twojej firmy: gwarantowane prawo do zmiany dostawcy.
Data Act
Rozporządzenie (UE) 2023/2854, stosowane od 12.09.2025: wypowiedzenie do dwóch miesięcy, okres przejściowy do 30 dni, otwarte interfejsy i eksport danych. Od 12.01.2027 obowiązuje zakaz pobierania opłat za samą zmianę dostawcy, w tym za wyjście danych.
NIS2 i KSC
Obowiązek zarządzania ryzykiem łańcucha dostaw i oceny każdego bezpośredniego dostawcy. Przepis nakazuje ocenę, nie narzuca jej wyniku.
DORA
Dla sektora finansowego: ryzyko koncentracji i przygotowana strategia wyjścia od dostawcy usług ICT.
Co dostajesz po przejściu do nas
Stała stawka w złotych, bez pozycji zależnych od kursu i bez rachunku za ruch wychodzący.
Faktury w systemie KSeF — dokument wchodzi do Twojego obiegu bez przepisywania.
Infrastruktura i dane pozostają w Unii Europejskiej, bez transferu poza Europejski Obszar Gospodarczy.
Cała maszyna zamiast rozmiaru instancji — konfigurację dobierasz Ty, nie tabela dostawcy.
08 · Uruchomienie
Od zamówienia do działającej maszyny
Osiem kroków, z których siedem przebiega automatycznie. Naliczanie okresu rozpoczyna się dopiero w ostatnim.
01
Zamówienie
konfiguracja i okres
02
Płatność
zaksięgowanie
03
Rezerwacja
przydział maszyny
04
Sieć
VLAN, adres IP, wpis DNS
05
Instalacja
start z sieci, zapis obrazu
06
Konfiguracja
sterowniki, klucze, zapora
07
Testy
odbiór techniczny
08
Aktywacja
dane dostępowe i start naliczania
Wariant maszyny
Linux
Windows
Dostępność procesu
Maszyna z kartą zarządzającą BMC
25–45 min
50–75 min
24/7, bez udziału człowieka
Stacja z urządzeniem KVM-over-IP
30–55 min
55–85 min
24/7, bez udziału człowieka
Maszyna bez sterowania out-of-band
2–8 h w godzinach pracy
3–10 h w godzinach pracy
poza godzinami — następny dzień roboczy
Uruchomienie do 60 minut w trybie 24/7 dotyczy maszyn wyposażonych w sterowanie out-of-band. Dla pozostałych maszyn obowiązuje termin z ostatniego wiersza tabeli, potwierdzany w ofercie.
05 · Serwery dla nauki
Zacznij od nazwy programu, nie od sprzętu
Dobór serwera pod konkretny program naukowy — od Ansysa i Abaqusa, przez GROMACS i AlphaFold, po Statę, Gurobiego i modele językowe. Każda karta podaje wymagania z dokumentacji producenta, mówi, co realnie decyduje o czasie liczenia, i pokazuje maszynę z katalogu razem z opłatą.
Jeśli do Twojego zadania wystarczy bezpłatna infrastruktura grantowa, poinformujemy Cię o tym i nie będziemy proponować najmu. Ta zakładka ma pomóc w wyborze.
30 z 30 kart programów
Okres najmu
Serwery dla nauki / CAE i inżynieria / CFD, przepływy i cząstki
Ansys Fluent
Ansys
solver GPU-nativelicencję wnosi klientPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Producent podaje 4–8 GB RAM na rdzeń i 1,8 GB VRAM na milion komórek polihedralnych w pojedynczej precyzji. Solver GPU-native nie wymaga FP64, ale w trybie 3ddp na kartach bez FP64 liczy — cytat Ansysa — „roughly half the speed”.
źródło:
Model licencji
HPC Pack — progi 12 / 36 / 132 rdzenie; karta GPU zajmuje slot HPC tak jak rdzeń Licencji Ansys nie odsprzedajemy i nie sublicencjonujemy — to zakup u autoryzowanego partnera. Dostarczamy maszynę dopasowaną do Twojej licencji. Licencja krajowa ICM działa spoza sieci uczelni pod warunkiem, że nasz stały publiczny IPv4 trafi do puli autoryzowanej przez Opiekuna Licencji.
Pozycje dodatkowe, wyceniane w ofercie: Pakiet licencyjny uczelniany — stały publiczny IPv4 i otwarte porty serwera licencji · Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-CAE-A6000-4 → TRDC-A6000-4 — Pozycja katalogowa ma 256 GB RAM; pakiet modelowy zakładał 512 GB. Wariant 512 GB w katalogu to TRDC-RACK-A6000-4 (barebone rackowy).
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
Czego ta maszyna nie przyspieszy
Generowania siatki — Fluent Meshing jest w znacznej części jednowątkowy.
Post-processingu w CFD-Post — to zadanie graficzne i I/O, nie solverowe.
Progu licencyjnego — przy większej liczbie rdzeni niż slotów HPC nadmiarowe rdzenie pozostają niewykorzystane.
Serwery dla nauki / CAE i inżynieria / MES i dynamika konstrukcji
Ansys Mechanical / APDL
Ansys
GPU przyspiesza częśćwymaga FP64licencję wnosi klientwymaga zdalnego pulpituPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Ansys liczy pamięć na model, nie na rdzeń: 15 GB RAM na milion stopni swobody. Solver sparse direct przyspiesza wyłącznie karta z rzeczywistym FP64 — iteracyjny PCG działa także na kartach RTX.
źródło:
Model licencji
HPC Pack — schodki 12 / 36 / 132 rdzenie Licencję Ansys wnosi klient — nie jesteśmy resellerem. Przy solverze sparse direct karta RTX nie da przyspieszenia: Ansys pisze o kartach RTX Ada i „the new RTX Pro cards”, że mają „little or no FP64 computational speed at all”.
Pozycje dodatkowe, wyceniane w ofercie: Pakiet licencyjny uczelniany — stały publiczny IPv4 i otwarte porty serwera licencji · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-CAE-A6000-4 → TRDC-A6000-4 — Pozycja katalogowa ma 256 GB RAM; pakiet modelowy zakładał 512 GB. Wariant 512 GB w katalogu to TRDC-RACK-A6000-4 (barebone rackowy).
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
Czego ta maszyna nie przyspieszy
Solvera sparse direct na kartach RTX — tam karta GPU nie przyspiesza obliczeń.
Pre- i post-processingu w Workbenchu — to praca w oknie, wymaga zdalnego pulpitu z akceleracją.
Serwery dla nauki / CAE i inżynieria / Elektromagnetyzm i elektronika
Ansys HFSS i Maxwell
Ansys
GPU przyspiesza częśćwymaga FP64licencję wnosi klientPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
8 GB RAM na rdzeń, a jedna karta liczy się jako 8 jednostek HPC. Ansys pisze wprost: „NVIDIA Workstation RTX and Quadro GPUs for all generations are not supported except for Quadro GV100” — akceleracja działa wyłącznie na kartach Data Center.
źródło:
Model licencji
HPC Pack — progi; 1 GPU = 8 jednostek HPC To jedyna rodzina w tym katalogu, dla której karty RTX nie są odpowiednie. Oferujemy tu wyłącznie maszyny z A100 — karta RTX byłaby błędem doboru, a nie oszczędnością.
Pozycje dodatkowe, wyceniane w ofercie: Pakiet licencyjny uczelniany — stały publiczny IPv4 i otwarte porty serwera licencji
SCI-FP64-A100-2 → TRDC-RACK-A100-2 — Pozycja katalogowa ma 512 GB RAM zamiast modelowych 256 GB.
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
Czego ta maszyna nie przyspieszy
Niczego na kartach RTX — producent ich nie wspiera w tych produktach.
Zadań, na które klient nie ma slotów HPC w licencji.
Serwery dla nauki / CAE i inżynieria / MES i dynamika konstrukcji
Abaqus/Standard
Dassault Systèmes SIMULIA
GPU przyspiesza częśćwymaga FP64licencję wnosi klientwymaga zdalnego pulpituPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
W praktyce około 8 GB RAM na rdzeń, a tokeny liczone są wzorem int(5·N^0,422): 24 rdzenie kosztują 19 tokenów, 48 rdzeni tylko 29 — więc opłaca się licencjonować większą liczbę rdzeni naraz. Akceleracja GPU wymaga podwójnej precyzji.
źródło:
Model licencji
tokeny DSLS — int(5·N^0,422), serwer licencji na portach 4085 i 2700–2701 Licencję Abaqusa wnosi klient. Serwer licencji stoi po stronie uczelni — potrzebny jest zarządzany tunel do portów DSLS albo nasz stały publiczny IPv4 w regule zapory klienta.
Pozycje dodatkowe, wyceniane w ofercie: Zarządzany tunel licencyjny SSH/VPN do serwera licencji uczelni · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP)
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
Czego ta maszyna nie przyspieszy
Abaqus/Explicit nie ma akceleracji GPU w ogóle — tam liczy się pasmo pamięci na rdzeń.
Modułu CAE w trybie graficznym — to praca w oknie, potrzebny zdalny pulpit.
Serwery dla nauki / CAE i inżynieria / CFD, przepływy i cząstki
OpenFOAM
open source (GPL)
brak akceleracji GPUPLGrid zwykle wystarcza
Co mówi dokumentacja producenta
Około 300 bajtów na komórkę i 10–15 tysięcy komórek na rdzeń dla dobrego skalowania: 48 rdzeni to około 720 tysięcy komórek optymalnie i do około 7 mln z zachowaniem dobrej wydajności. Poza wtyczkami AmgX kod nie korzysta z GPU.
źródło:
Model licencji
GPL — bez opłat za rdzenie i bez limitu licencyjnego
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-CPU-96 → TRDC-A6000-2-M — Węzeł 96-rdzeniowy pakietu modelowego opiera się na stacji Lenovo ThinkStation P8 w konfiguracji spoza katalogu wynajmu. Najwięcej rdzeni fizycznych wśród stacji ma TR DC 4000 Solo P8 — 96 rdzeni fizycznych; w całym katalogu TR DC Rack 6000 2 (1,5 TB) — 320 rdzeni fizycznych. Konfigurację P8 przyjmujemy wyłącznie na zapytanie.
Czego ta maszyna nie przyspieszy
Skalowania na wiele maszyn — nasza sieć to 1/10/25 GbE bez RDMA, solver rozproszony traci skalowanie już na drugim węźle.
Zadań poniżej 10 tysięcy komórek na rdzeń — tam zwiększanie liczby rdzeni obniża wydajność.
Serwery dla nauki / Budownictwo i geotechnika / Konstrukcje budowlane
Dlubal RFEM 6 / RSTAB 9
Dlubal
GPU tylko do wyświetlanialicencję wnosi klientwyłącznie Windowswymaga zdalnego pulpituPLGrid niedostępny
Co mówi dokumentacja producenta
Wymaga OpenGL 4.2 lub nowszego i 1–3 GB RAM na wątek; karta służy wyłącznie do wyświetlania. Program działa tylko na Windows, a część wdrożeń pracuje na kluczu sprzętowym USB.
źródło:
Model licencji
per użytkownik — klucz lokalny albo licencja sieciowa Licencję wnosi klient. Windows nie jest wliczony w cenę maszyny — Windows 11 Pro nie jest dostępny w naszej ofercie; Windows Enterprise oferujemy w modelu SPLA jako osobną pozycję abonamentu. Klucz sprzętowy USB wymaga urządzenia USB-over-IP, ponieważ klucza nie można podłączyć bezpośrednio do maszyny w serwerowni.
Pozycje dodatkowe, wyceniane w ofercie: Windows Enterprise w modelu SPLA — osobna pozycja abonamentu, poza ceną maszyny · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP) · Urządzenie USB-over-IP dla klucza sprzętowego
Obliczeń, które i tak biegną na jednym wątku — większa maszyna ich nie skróci.
Pracy w oknie bez zdalnego pulpitu z akceleracją — bez niego interfejs graficzny nie nadaje się do pracy.
Serwery dla nauki / Budownictwo i geotechnika / BIM i obciążenia środowiskowe
Autodesk Revit i Navisworks
Autodesk
GPU tylko do wyświetlanialicencję wnosi klientwyłącznie Windowswymaga zdalnego pulpituPLGrid niedostępny
Co mówi dokumentacja producenta
Producent zaleca co najmniej 8 GB VRAM dla trybu Accelerated Graphics i 16–32 GB RAM na maszynę; model federacyjny w Navisworks może przekroczyć 2 GB. Program działa wyłącznie na Windows.
źródło:
Model licencji
per użytkownik — subskrypcja Autodesk Licencji edukacyjnej Autodesk nie wolno używać w spółce spin-off ani przy pracy zleconej — warunki mówią „solely for Educational Purposes and shall not be used for commercial, professional, or any other for-profit purposes”. Do pracy zarobkowej potrzebna jest licencja komercyjna klienta.
Pozycje dodatkowe, wyceniane w ofercie: Windows Enterprise w modelu SPLA — osobna pozycja abonamentu, poza ceną maszyny · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP)
Obliczeń Revita, które są jednowątkowe — tam decyduje taktowanie rdzenia, nie ich liczba.
Pracy bez zdalnego pulpitu z akceleracją.
Serwery dla nauki / Chemia i materiałoznawstwo / Chemia kwantowa molekularna
Gaussian 16
Gaussian, Inc.
GPU przyspiesza częśćwymaga FP64licencję wnosi klientPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Minimum 4 GB RAM na rdzeń, a pojedyncze zadanie zajmuje 50–70% pamięci systemu — przy 48 rdzeniach to co najmniej 320 GB. Lista wspieranych kart kończy się na A100 i dotyczy wyłącznie DFT; metody MP2 i CCSD nie używają GPU wcale.
źródło:
Model licencji
płatna, wieczysta per site Licencję Gaussiana wnosi klient. Licencja krajowa ICM jest wykonywana na maszynach ośrodka i nie można jej przenieść na naszą maszynę. W takim przypadku potrzebna jest własna licencja albo dalsza praca w PLGrid. Żadna karta RTX nie jest na liście wspieranych GPU.
Pozycje dodatkowe, wyceniane w ofercie: Pakiet licencyjny uczelniany — stały publiczny IPv4 i otwarte porty serwera licencji · Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
Czego ta maszyna nie przyspieszy
Metod MP2 i CCSD — one nie korzystają z GPU w ogóle.
Zadań na kartach Ada i Blackwell — nie ma ich na liście wspieranych.
Serwery dla nauki / Chemia i materiałoznawstwo / DFT plane-wave i ciało stałe
VASP 6
VASP Software GmbH
solver GPU-nativewymaga FP64licencję wnosi klientPLGrid zwykle wystarcza
Co mówi dokumentacja producenta
Kod wymaga sprzętowej podwójnej precyzji: na kartach RTX proporcja FP64 wynosi 1:64 zamiast 1:2, więc liczy 5–10 razy wolniej. Potrzebuje 8 GB RAM na rdzeń i VRAM co najmniej dwukrotnie większego od pliku WAVECAR.
źródło:
Model licencji
płatna, licencjonowana per grupa badawcza Licencję VASP wnosi klient — jest przypisana do grupy badawczej. Licencja krajowa ICM jest wykonywana na maszynach ośrodka i nie da się jej przenieść na naszą maszynę.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-FP64-A100-2 → TRDC-RACK-A100-2 — Pozycja katalogowa ma 512 GB RAM zamiast modelowych 256 GB.
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
SCI-AI-H200-4 → TRDC-RACK-H200-4 — Pozycja katalogowa ma 1 TB RAM zamiast modelowych 512 GB.
Czego ta maszyna nie przyspieszy
Niczego na kartach RTX — tam kod jest 5–10 razy wolniejszy niż na A100.
Zadań rozproszonych na wiele maszyn — wymagają sieci o niskich opóźnieniach, której ta oferta nie obejmuje.
Serwery dla nauki / Chemia i materiałoznawstwo / Chemia kwantowa molekularna
ORCA 6
FACCTs / MPI
brak akceleracji GPUlicencję wnosi klientPLGrid zwykle wystarcza
Co mówi dokumentacja producenta
ORCA nie ma akceleracji GPU — karta jest tu zbędna. DLPNO-CCSD(T) potrzebuje 4–16 GB RAM na rdzeń, czyli przy 48 rdzeniach do 768 GB.
źródło:
Model licencji
darmowa akademicko, komercyjnie płatna u FACCTs Do zastosowań komercyjnych potrzebna jest licencja od FACCTs — bezpłatność dotyczy wyłącznie użytku akademickiego.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
SCI-CPU-96 → TRDC-A6000-2-M — Węzeł 96-rdzeniowy pakietu modelowego opiera się na stacji Lenovo ThinkStation P8 w konfiguracji spoza katalogu wynajmu. Najwięcej rdzeni fizycznych wśród stacji ma TR DC 4000 Solo P8 — 96 rdzeni fizycznych; w całym katalogu TR DC Rack 6000 2 (1,5 TB) — 320 rdzeni fizycznych. Konfigurację P8 przyjmujemy wyłącznie na zapytanie.
Czego ta maszyna nie przyspieszy
Niczego przez dołożenie karty — ORCA nie ma ścieżki GPU.
Zadań ograniczonych pamięcią na rdzeń — tam pomaga tylko więcej RAM, nie więcej rdzeni.
Serwery dla nauki / Biologia molekularna i leki / Dynamika molekularna
GROMACS
open source (LGPL 2.1)
solver GPU-nativePLGrid zwykle wystarcza
Co mówi dokumentacja producenta
Kod liczy w mieszanej precyzji, więc podwójna precyzja sprzętowa jest tu zbędna — karty RTX PRO są szybsze i tańsze od A100. Potrzebuje 4–8 GB RAM na rdzeń i 8–24 GB VRAM, a wersja podwójnej precyzji gmx_d nie korzysta z GPU.
źródło:
Model licencji
LGPL 2.1 — darmowa, bez limitu rdzeni
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Obliczeń w pełnej podwójnej precyzji — wersja gmx_d nie korzysta z GPU.
Skalowania na wiele maszyn — bez sieci o niskich opóźnieniach skalowanie nie przynosi korzyści.
Serwery dla nauki / Biologia molekularna i leki / Dynamika molekularna
AMBER (pmemd.cuda)
Amber / UCSF
solver GPU-nativelicencję wnosi klientPLGrid zwykle wystarcza
Co mówi dokumentacja producenta
Autorzy piszą wprost: „our algorithms cannot scale to multiple GPUs” — jedna symulacja to jedna karta. Opłaca się więc maszyna wielokartowa z tańszym procesorem: 8–24 GB VRAM i 32–64 GB RAM na kartę.
źródło:
Model licencji
AmberTools na GPL; Amber26 darmowy akademicko Dla przemysłu Amber26 kosztuje 25 000 $ — licencję wnosi klient. Bezpłatność dotyczy wyłącznie zastosowań akademickich.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Pojedynczej symulacji przez dołożenie kart — jedna trajektoria jest zawsze liczona na jednej karcie.
Zadań ograniczonych częścią CPU — pmemd.cuda przenosi na kartę praktycznie całość.
Serwery dla nauki / Biologia molekularna i leki / Struktura białek i projektowanie leków
AlphaFold 3
Google DeepMind
solver GPU-nativelicencję wnosi klientPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Oficjalnie wymaga karty z 80 GB VRAM klasy A100 lub H100 i co najmniej 64 GB RAM. Kod jest na Apache 2.0, ale wagi modelu mają osobne warunki użycia.
źródło:
Model licencji
kod Apache 2.0; wagi na osobnych Terms of Use Wagi AlphaFold 3 są udostępniane na wniosek i wyłącznie do zastosowań niekomercyjnych — dostęp klient uzyskuje samodzielnie, bez naszego pośrednictwa. Dla zastosowań komercyjnych alternatywą są AlphaFold 2 (CC BY 4.0), OpenFold (Apache 2.0) i ESMFold (MIT).
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-FP64-A100-2 → TRDC-RACK-A100-2 — Pozycja katalogowa ma 512 GB RAM zamiast modelowych 256 GB.
SCI-FP64-A100-4 → TRDC-RACK-A100-4 — W katalogu ta konfiguracja jest dostępna na serwerze rackowym Supermicro, nie na stacji PX.
SCI-AI-H200-4 → TRDC-RACK-H200-4 — Pozycja katalogowa ma 1 TB RAM zamiast modelowych 512 GB.
Czego ta maszyna nie przyspieszy
Treningu modelu od zera — to zadanie dla dziesiątek kart pracujących tygodniami w sieci InfiniBand, poza zakresem tej oferty.
Etapu wyszukiwania MSA, który obciąża procesor i dysk, nie kartę.
Serwery dla nauki / Biologia molekularna i leki / Kriomikroskopia
RELION 5
open source (GPL-2.0)
solver GPU-nativePLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Dokumentacja mówi wprost: „you don't need the expensive double-precision cards”. Kernele CPU korzystają z AVX-512 i przy nich autorzy zalecają 256 GB RAM i więcej; VRAM 11–48 GB.
źródło:
Model licencji
GPL-2.0 — darmowa
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Dwie karty wymagają co najmniej 100 GB RAM, cztery — 196 GB. Na kartę potrzeba minimum 16 GB VRAM, rna_fq2bam wymaga 24 GB, a giraffe 40 GB, więc karta 24 GB tu nie wystarcza.
źródło:
Model licencji
NVIDIA EULA — obrazy bezpłatne z katalogu NGC Obrazy kontenerów klient pobiera z własnego konta NGC. Sterownika NVIDIA nie instalujemy na maszynie wydawanej klientowi — punkt 2.7 licencji sterownika zabrania świadczenia komercyjnego hostingu z tym oprogramowaniem. Maszynę przekazujemy bez sterownika, ze zwersjonowanym skryptem instalacyjnym w katalogu domowym; komendę uruchamia klient ze swojego konta.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program) · Instalacja stosu — pełna z walidacją i protokołem odbioru
Etapów, które i tak są ograniczone dyskiem — potok WGS to 500 GB – 1 TB ruchu na próbkę.
Zadań na kartach 24 GB — giraffe się na nich nie uruchomi.
Serwery dla nauki / Genomika i bioinformatyka / Mapowanie i warianty
GATK 4
Broad Institute
brak akceleracji GPUPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Potrzebuje 4–8 GB RAM na shard i 32–64 GB na węzeł, a 24 równoległe zadania scatter-gather to 24 niezależne strumienie wejścia-wyjścia — decyduje lokalny NVMe, nie dysk sieciowy. Na próbkę WGS liczy się 300–500 GB miejsca.
źródło:
Model licencji
BSD-3 — darmowa
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu obliczeniowego — podstawowa
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
Czego ta maszyna nie przyspieszy
Niczego przez kartę graficzną — to potok czysto procesorowy.
Zadań, które nie mieszczą się w pamięci — poniżej progu proces zostaje przerwany.
Serwery dla nauki / Genomika i bioinformatyka / Składanie de novo i transkryptomy
SPAdes
open source (GPLv2)
brak akceleracji GPUPLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
Domyślny limit pamięci ustawiony flagą -m to 250 GB, ale duże zbiory potrzebują 500–1 000 GB. W całym tym dziale to jedyna klasa zadań, w której o doborze maszyny decyduje wyłącznie pamięć operacyjna.
źródło:
Model licencji
GPLv2 — darmowa
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu obliczeniowego — podstawowa
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
Czego ta maszyna nie przyspieszy
Koasemblacji wielkich metagenomów i części genomów roślinnych — te zbiory wychodzą poza 1 TB i na obu maszynach powyżej się nie złożą. Katalog wynajmu sięga jednak znacznie wyżej: do 3 072 GB RAM (TR DC Rack L40S 8 (3 TB)), a pozycji z co najmniej 1,5 TB RAM jest w nim 7 — taką maszynę dobieramy w zapytaniu ofertowym.
Niczego przez kartę graficzną.
Serwery dla nauki / Obrazowanie medyczne / Segmentacja i AI medyczne
MONAI
Project MONAI
solver GPU-nativePLGrid niedostępny
Co mówi dokumentacja producenta
Praktyczne minimum to 16 GB VRAM, a modele trójwymiarowe wymagają 48–96 GB. Pamięć operacyjna powinna być dwu- do czterokrotnie większa od VRAM.
źródło:
Model licencji
Apache-2.0 — darmowa
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Wczytywania danych, jeśli są przechowywane na dysku sieciowym — potok DICOM to strumień drobnych plików.
Zadań 3D na kartach poniżej 48 GB — nie zmieszczą się w pamięci karty.
Serwery dla nauki / Obrazowanie medyczne / Segmentacja i AI medyczne
nnU-Net
DKFZ
solver GPU-nativePLGrid niedostępny
Co mówi dokumentacja producenta
Trening wymaga co najmniej 10 GB VRAM, inferencja 4 GB wolnej pamięci karty, a do tego 6 rdzeni fizycznych i 64 GB RAM na stacji. Dokumentacja rekomenduje karty GeForce, których licencja sterownika nie dopuszcza do pracy w centrum danych.
źródło:
Model licencji
Apache-2.0 — darmowa Kart GeForce nie oferujemy: zgodnie z licencją sterownika NVIDIA nie są one licencjonowane do wdrożeń w centrum danych. Oferujemy karty RTX PRO i RTX A6000 — dopuszczone do takich wdrożeń i z dwukrotnie większym VRAM niż karty z dokumentacji.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Parallel Computing Toolbox uruchamia lokalnie do 512 workerów i nie limituje rdzeni, ale licencja wiąże się z host ID maszyny. Zadania mieszczą się w 32–256 GB RAM, a gpuArray korzysta z 24–96 GB VRAM.
źródło:
Model licencji
per toolbox; Designated Computer wiąże się z host ID Licencję MATLAB-a wnosi klient. Licencja powiązana z host ID wymaga ponownej aktywacji po wymianie maszyny w ramach SLA — umowa określa, że ponowną aktywację licencji klient przeprowadza po swojej stronie. Serwer licencji uczelni obsługujemy zarządzanym tunelem (porty 1721–1722).
Pozycje dodatkowe, wyceniane w ofercie: Zarządzany tunel licencyjny SSH/VPN do serwera licencji uczelni · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-CPU-96 → TRDC-A6000-2-M — Węzeł 96-rdzeniowy pakietu modelowego opiera się na stacji Lenovo ThinkStation P8 w konfiguracji spoza katalogu wynajmu. Najwięcej rdzeni fizycznych wśród stacji ma TR DC 4000 Solo P8 — 96 rdzeni fizycznych; w całym katalogu TR DC Rack 6000 2 (1,5 TB) — 320 rdzeni fizycznych. Konfigurację P8 przyjmujemy wyłącznie na zapytanie.
Czego ta maszyna nie przyspieszy
Kodu, który nie został zrównoleglony — sam PCT nie przyspiesza pętli napisanej szeregowo.
Zadań zrównoleglonych rdzeniami na wariancie pod gpuArray — tam rdzeni fizycznych jest mniej niż w pozycji zalecanej.
Pracy w oknie MATLAB-a bez zdalnego pulpitu z akceleracją.
Serwery dla nauki / Ekonometria i statystyka / Pakiety statystyczne
Stata/MP
StataCorp
brak akceleracji GPUlicencję wnosi klientlicencja ogranicza liczbę rdzeniwymaga zdalnego pulpituPLGrid niedostępny
Co mówi dokumentacja producenta
Licencja jest kupowana na konkretną liczbę rdzeni (MP2 do MP64), więc większa maszyna nie tylko nie pomoże, ale podnosi rachunek klienta. Pamięć liczy się jako półtorakrotność zbioru — 1 TB RAM obsługuje zbiór 660 GB.
źródło:
Model licencji
komercyjna, per liczba rdzeni (MP2…MP64) — twardy limit Licencję Staty wnosi klient. Liczbę aktywnych rdzeni ustawiamy fizycznie w BIOS-ie pod plik licencji — nie obchodzimy limitu kontenerem ani wirtualizacją, bo to złamałoby regułę „jeden klient, jedna cała fizyczna maszyna”.
Pozycje dodatkowe, wyceniane w ofercie: Fizyczne ograniczenie liczby aktywnych rdzeni w BIOS pod plik licencji · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
Czego ta maszyna nie przyspieszy
Niczego powyżej limitu rdzeni z licencji — nadmiarowe rdzenie pozostają niewykorzystane.
Stata/SE i /BE liczą efektywnie na jednym rdzeniu — tam większa maszyna nie skróci obliczeń.
Serwery dla nauki / Ekonometria i statystyka / Pakiety statystyczne
SAS 9.4
SAS Institute
brak akceleracji GPUlicencję wnosi klientlicencja ogranicza liczbę rdzeniwymaga zdalnego pulpituPLGrid niedostępny
Co mówi dokumentacja producenta
Historycznie licencjonowany per rdzeń, w kontrakcie wieloletnim z metryką pojemnościową; zadania mieszczą się w 32–128 GB RAM. SAS Viya 4 odchodzi od licencji per rdzeń i tam uzasadniony jest wybór największej maszyny.
źródło:
Model licencji
komercyjna, historycznie per rdzeń SAS-a nie sprzedajemy w abonamencie — wyłącznie model „przynieś własną licencję”. Metryka pojemnościowa i wieloletni kontrakt z SAS Institute pozostają po stronie klienta. Limit rdzeni ustawiamy fizycznie w BIOS-ie.
Pozycje dodatkowe, wyceniane w ofercie: Fizyczne ograniczenie liczby aktywnych rdzeni w BIOS pod plik licencji · Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP)
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
Czego ta maszyna nie przyspieszy
Niczego powyżej opłaconej liczby rdzeni — większa maszyna podnosi rachunek licencyjny klienta.
Zadań ograniczonych dyskiem — projekty SAS mogą zajmować od 200 GB do 2 TB.
Serwery dla nauki / Ekonometria i statystyka / Optymalizacja i badania operacyjne
Gurobi
Gurobi Optimization
brak akceleracji GPUlicencję wnosi klientlicencja ogranicza liczbę rdzeniPLGrid niedostępny
Co mówi dokumentacja producenta
Plik licencji zawiera maksymalną liczbę rdzeni fizycznych, a jej przekroczenie kończy się błędem ERROR 10009 i solver w ogóle się nie uruchamia. Modele mieszczą się w 32–512 GB RAM.
źródło:
Model licencji
komercyjna albo akademicka WLS — plik licencji ogranicza liczbę rdzeni fizycznych Licencję Gurobiego wnosi klient. Producent sugeruje obejście limitu rdzeni kontenerem — my tego nie robimy, bo to wirtualizacja sprzeczna z regułą „jeden klient, jedna cała fizyczna maszyna”. Zamiast tego wyłączamy rdzenie fizycznie w BIOS-ie i wydajemy maszynę z dokładnie tyloma rdzeniami, ile określa plik licencji.
Pozycje dodatkowe, wyceniane w ofercie: Fizyczne ograniczenie liczby aktywnych rdzeni w BIOS pod plik licencji
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-CPU-96 → TRDC-A6000-2-M — Węzeł 96-rdzeniowy pakietu modelowego opiera się na stacji Lenovo ThinkStation P8 w konfiguracji spoza katalogu wynajmu. Najwięcej rdzeni fizycznych wśród stacji ma TR DC 4000 Solo P8 — 96 rdzeni fizycznych; w całym katalogu TR DC Rack 6000 2 (1,5 TB) — 320 rdzeni fizycznych. Konfigurację P8 przyjmujemy wyłącznie na zapytanie.
Czego ta maszyna nie przyspieszy
Niczego powyżej limitu z pliku licencji — solver się nie uruchomi i zwróci ERROR 10009.
Modeli, które są trudne kombinatorycznie, a nie pamięciowo.
Serwery dla nauki / Uczenie maszynowe i modele językowe / Inference modeli językowych
vLLM
open source (Apache 2.0)
solver GPU-nativePLGrid niedostępny
Co mówi dokumentacja producenta
Działa wyłącznie na Linuksie, a pamięć operacyjna powinna być co najmniej równa łącznemu VRAM. Zapotrzebowanie na pamięć kart rozciąga się od 24 GB dla małych modeli po 564 GB dla modelu 405B w INT4 z dużym cache KV.
źródło:
Model licencji
Apache 2.0 — darmowa Konfiguracja „vLLM na Windows” nie jest przez nas wspierana — producent vLLM nie wspiera systemu Windows; uruchomienie przez WSL2 jest możliwe, ale bez wsparcia. Na Windows oferujemy Ollama i llama.cpp. Za licencje samych modeli (od Apache po warianty niekomercyjne i gated) odpowiada klient.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-LLM-6000-2 → TRDC-RACK-6000-2 — Konfiguracja pakietu modelowego odpowiada pozycji katalogowej na platformie ASUS ESC4000A.
SCI-AI-H200-4 → TRDC-RACK-H200-4 — Pozycja katalogowa ma 1 TB RAM zamiast modelowych 512 GB.
Czego ta maszyna nie przyspieszy
Modelu 405B w pełnym FP16 (około 1 012 GB VRAM) na żadnej z maszyn pokazanych powyżej. Obsługuje go dopiero najwyższa konfiguracja w katalogu — 1 128 GB VRAM (TR DC Rack H200 8 (2 TB)); to pozycja spoza tego zestawienia, dobierana w zapytaniu ofertowym.
Tensor parallel na kartach Blackwell PRO — te karty nie mają mostka NVLink (Lenovo PSREF), więc komunikują się wyłącznie przez PCIe 5.0.
Serwery dla nauki / Uczenie maszynowe i modele językowe / Inference modeli językowych
Ollama / llama.cpp i Bielik
open source (MIT / Apache 2.0)
solver GPU-nativePLGrid niedostępny
Co mówi dokumentacja producenta
To jedyna droga do modeli językowych na Windows. Bielik 11B w pełnym FP16 zajmuje 22 GB i mieści się na jednej karcie, a Whisper w wariancie large potrzebuje około 10 GB VRAM.
źródło:
Model licencji
MIT / Apache 2.0 — darmowe; Bielik na Apache 2.0 Za zgodność z licencją konkretnego modelu odpowiada klient — wagi na Hugging Face bywają na licencjach niekomercyjnych albo z dostępem na wniosek (gated).
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
SCI-LLM-6000-2 → TRDC-RACK-6000-2 — Konfiguracja pakietu modelowego odpowiada pozycji katalogowej na platformie ASUS ESC4000A.
Czego ta maszyna nie przyspieszy
Modeli, które nie mieszczą się w pamięci karty — zejście na pamięć systemową znacząco spowalnia generowanie.
Trenowania modeli — to narzędzia do wnioskowania, nie do treningu.
Serwery dla nauki / Uczenie maszynowe i modele językowe / Trening i fine-tuning
Unsloth / Axolotl
open source (Apache 2.0)
solver GPU-nativePLGrid: zależy od danych i zastosowania komercyjnego
Co mówi dokumentacja producenta
QLoRA na modelu 70B potrzebuje 46 GB VRAM, LoRA w 16 bitach dla 70B już 164 GB, a cztery modele 70B w QLoRA równolegle zajmują do 384 GB. Pamięć operacyjna powinna być co najmniej dwukrotnie większa od VRAM.
źródło:
Model licencji
Apache 2.0 — darmowe Licencja modelu bazowego jest odpowiedzialnością klienta — dotrenowanie modelu na wagach niekomercyjnych nie zmienia ich licencji.
Pozycje dodatkowe, wyceniane w ofercie: Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Pełnego fine-tuningu modelu 405B w 16 bitach (około 950 GB VRAM) na żadnej z maszyn pokazanych powyżej. Próg ten przekracza dopiero najwyższa konfiguracja w katalogu — 1 128 GB VRAM (TR DC Rack H200 8 (2 TB)); dobieramy ją w zapytaniu ofertowym.
Treningu modelu od zera — to zadanie dla klastra z siecią InfiniBand, poza zakresem tej oferty.
Serwery dla nauki / GIS i dane przestrzenne / GIS i bazy przestrzenne
QGIS i PostGIS
open source (GPL)
GPU tylko do wyświetlaniawymaga zdalnego pulpituPLGrid niedostępny
Co mówi dokumentacja producenta
QGIS pracuje w oknie i mieści się w 16–64 GB RAM, natomiast PostGIS jako usługa ciągła rośnie od 32 GB do 1 TB razem z bazą. To usługa działająca bez przerwy — czego infrastruktura grantowa nie daje.
źródło:
Model licencji
GPL — darmowa
Pozycje dodatkowe, wyceniane w ofercie: Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP) · Instalacja stosu obliczeniowego — podstawowa
SCI-MEM-768 → TRDC-A6000-2-M — Dla zapotrzebowania 768 GB bez karty proponujemy TRDC-A6000-2-M z pełnym 1 TB RAM — tańszą od każdej maszyny 512 GB w katalogu.
SCI-MEM-1TB → TRDC-A6000-2-M — Węzeł pamięciowy 1 TB oferujemy jako TRDC-A6000-2-M — ta sama platforma P920 i 1 TB RAM, z dwiema kartami RTX A6000 w cenie opłaty.
Czego ta maszyna nie przyspieszy
Zapytań przestrzennych bez indeksów — tam decyduje schemat bazy, nie maszyna.
Renderowania map w QGIS bez zdalnego pulpitu z akceleracją.
Serwery dla nauki / Grafika 3D i rekonstrukcja / Rekonstrukcja 3D i rendering
Blender
Blender Foundation (GPL)
solver GPU-nativewymaga zdalnego pulpitupotwierdzenie w oferciePLGrid niedostępny
Co mówi dokumentacja producenta
Blender jest typowym oprogramowaniem kierunków graficznych i rekonstrukcji 3D. Zasada praktyczna: cała scena musi zmieścić się w pamięci karty, a praca w oknie wymaga zdalnego pulpitu z akceleracją.
źródło:
Model licencji
GPL — darmowa
Pozycje dodatkowe, wyceniane w ofercie: Zdalny pulpit z akceleracją (Linux VirtualGL+TurboVNC albo Windows RDP) · Instalacja stosu — dziedzinowa (kompilacja pod konkretny program)
Symulacji fizycznych i etapów jednowątkowych — nie są liczone na karcie.
Scen większych niż pamięć karty — przeniesienie danych do pamięci systemowej znacząco wydłuża renderowanie.
Nauka i uczelnie — wybierz maszynę po nazwie oprogramowania
Do czego to służy
Dziesięć dziedzin katalogu odpowiada temu, jak dzieli się praca obliczeniowa na uczelniach i w jednostkach badawczych.
Mechanika obliczeniowa i CAE: Ansys Fluent, Ansys Mechanical, HFSS i Maxwell, Abaqus/Standard, OpenFOAM.
Budownictwo i geotechnika: Dlubal RFEM 6 i RSTAB 9, Autodesk Revit oraz Navisworks.
Chemia i materiałoznawstwo: Gaussian 16, VASP 6, ORCA 6.
Biologia molekularna: GROMACS, AMBER z modułem pmemd.cuda, AlphaFold 3.
Genomika i bioinformatyka: NVIDIA Parabricks, GATK 4, Cell Ranger, SPAdes.
Obrazowanie i mikroskopia: RELION 5, cryoSPARC.
Ekonometria, statystyka, uczenie maszynowe, GIS i grafika 3D: pakiety liczone na rdzeniach procesora oraz zadania korzystające z karty.
Wymagania sprzętowe różnią się między tymi grupami bardziej niż między dziedzinami. Solwery CAE i chemia kwantowa potrzebują obliczeń podwójnej precyzji oraz dużej pamięci na rdzeń, składanie genomów i duże modele MES wymagają pamięci systemowej liczonej w setkach gigabajtów, a uczenie modeli i rekonstrukcja obrazu korzystają przede wszystkim z pamięci karty.
Porównanie i dobór
Dwie informacje o programie decydują o wyborze maszyny szybciej niż tabela parametrów. Pierwsza to obecność akceleracji GPU: ORCA 6 liczy wyłącznie na procesorze, więc karta w takiej konfiguracji pozostaje nieużywana, a budżet warto przenieść na rdzenie i pamięć. Druga to model licencji: VASP wymaga licencji przypisanej do grupy badawczej, którą wnosi zespół uruchamiający obliczenia.
Do maszyn prowadzą trzy działy. Zadania pamięciowe, takie jak COMSOL, OpenFOAM, Abaqus, Gaussian czy składanie genomów w SPAdes, trafiają na węzeł z 1 TB pamięci systemowej w dziale stacje robocze. Obliczenia podwójnej precyzji i trening modeli idą na karty A100 w dziale serwery GPU PCIe. Największe modele językowe obsługuje dział serwery DGX. Dla postępowań zakupowych przygotowujemy opis przedmiotu zamówienia językiem specyfikacji technicznej, z parametrami maszyny i okresem najmu.
Najczęstsze pytania
Czy muszę mieć własną licencję oprogramowania?
Licencje programów naukowych wnosi użytkownik. Przykładem jest VASP, którego licencja przypisana jest do konkretnej grupy badawczej i podąża za zespołem, a nie za maszyną.
Czy każdy program skorzysta z karty graficznej?
Nie każdy. ORCA 6 liczy w całości na procesorze, a wiele solwerów CAE przyspiesza tylko wybrane etapy obliczeń. Przy takich programach lepiej dobrać maszynę o większej liczbie rdzeni i pamięci niż o mocniejszej karcie.
Skąd wiadomo, ile pamięci potrzebuje mój program?
Z wymagań producenta i z progu pamięci na rdzeń przypisanego do programu. Ten próg mnożony przez liczbę rdzeni daje dolną granicę pamięci systemowej, poniżej której obliczenie zwalnia albo przerywa pracę.
Które maszyny liczą w podwójnej precyzji?
Konfiguracje z kartami A100 80 GB w dziale serwerów GPU PCIe. Podwójnej precyzji wymagają między innymi Ansys Fluent w trybie 3ddp, Abaqus/Standard, VASP, Quantum ESPRESSO, CP2K i Gaussian.
Jak wygląda rozliczenie dla jednostki publicznej?
Stała opłata miesięczna w złotych netto, w okresie miesięcznym, półrocznym albo rocznym, na fakturę wystawianą w systemie KSeF. Jednorazowa opłata wdrożeniowa dotyczy najmu na 1 i 6 miesięcy (serwery GPU PCIe, stacje robocze) albo tylko najmu na 1 miesiąc (serwery DGX, stacje AI); przy umowie na 12 miesięcy jej nie pobieramy.
Czym dobór maszyny do CAE różni się od doboru pod uczenie modeli?
Punktem ciężkości. W CAE liczą się rdzenie fizyczne, pamięć na rdzeń i podwójna precyzja, więc rośnie znaczenie procesora i pojemności RAM. Przy uczeniu modeli decyduje pamięć karty, ponieważ to ona wyznacza największy model mieszczący się w jednym przebiegu.