cała maszyna
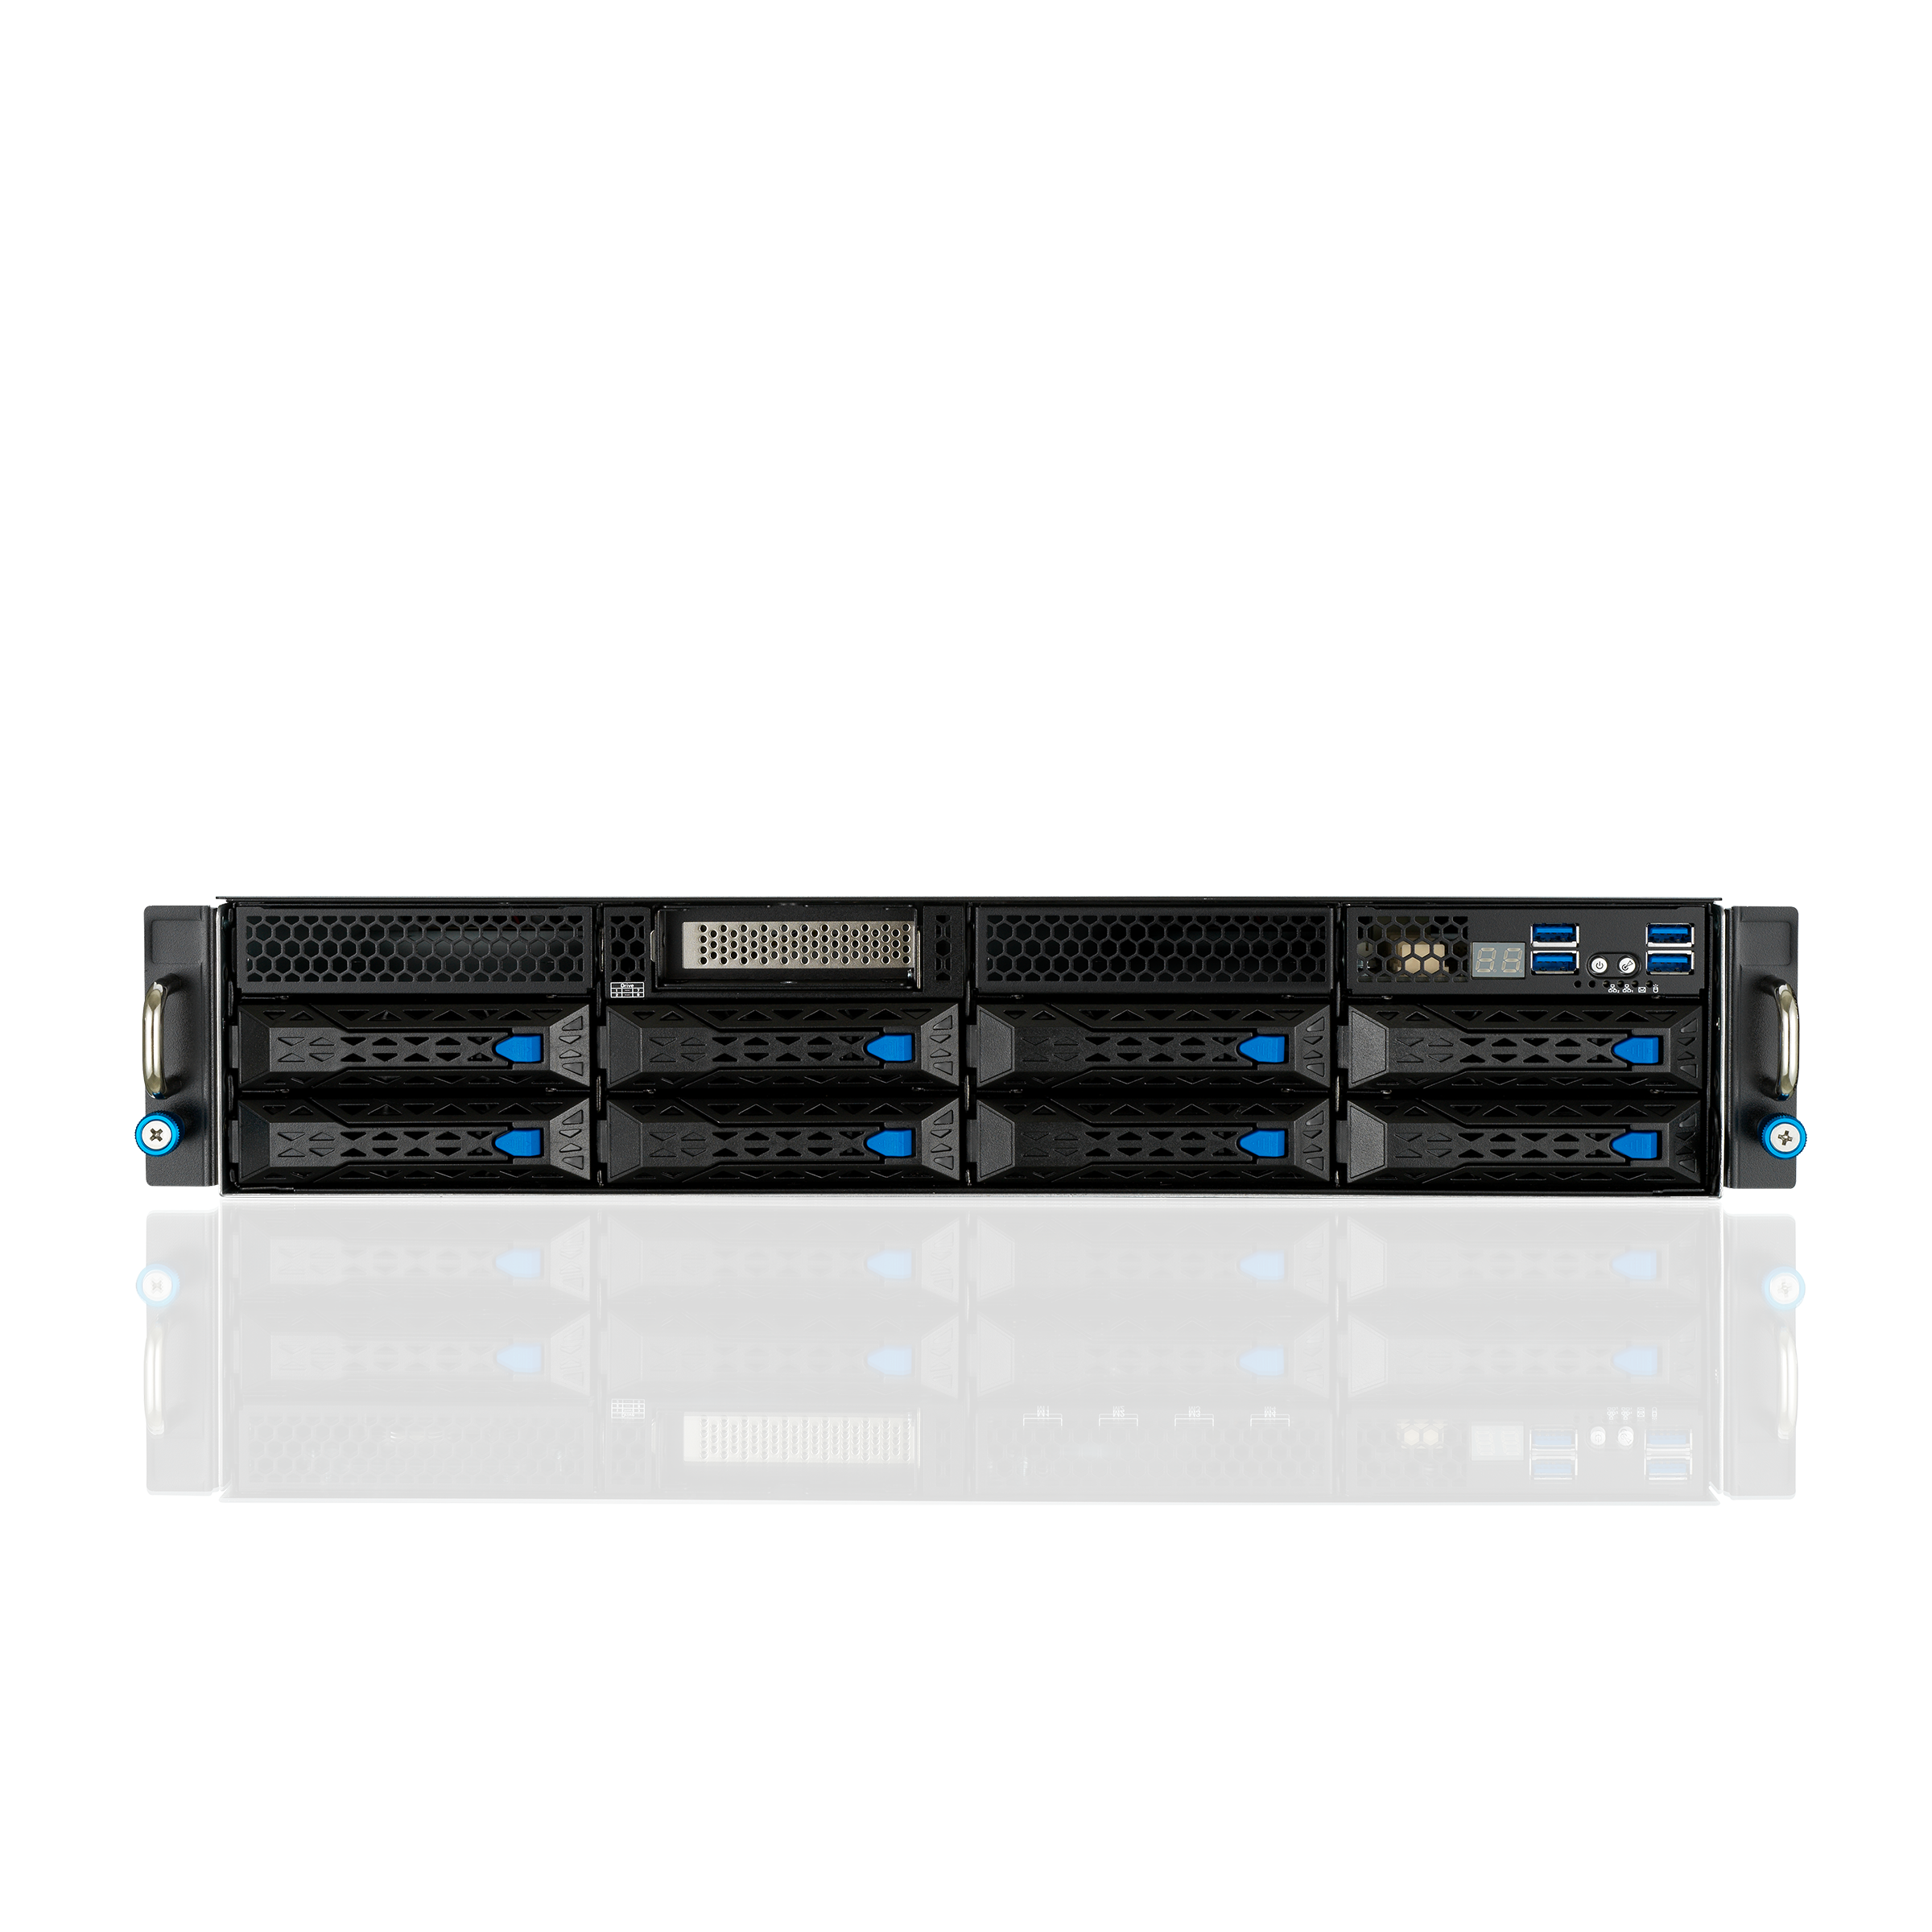
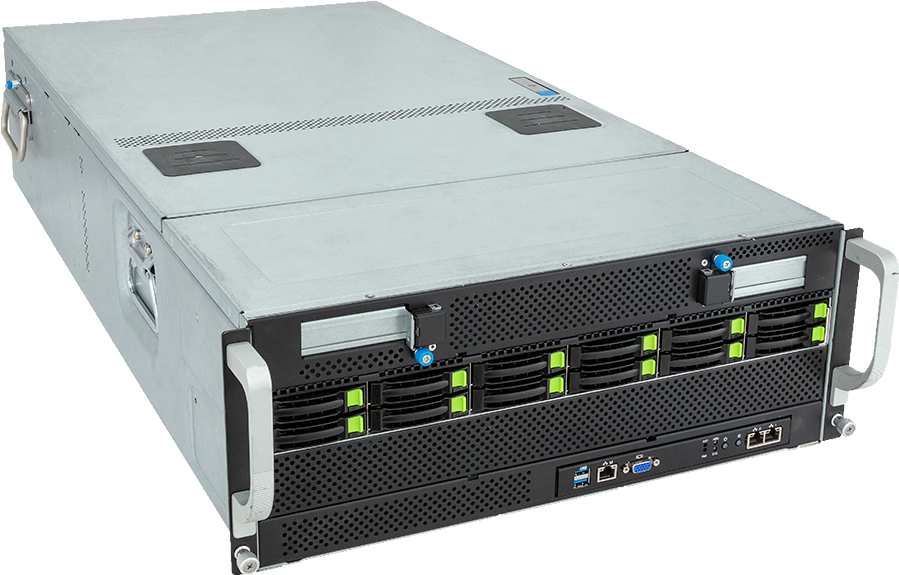
ASUS ESC4000A-E11-22WGP · TRDC-RACK-L40S-2

TR DC Rack L40S 2
- Karty
- 2× L40S 48 GB
- Rdzenie
- 32 fizyczne
- RAM
- 256 GB · 0,40 TB NVMe
termin w ofercie


8 100zł netto / mies.
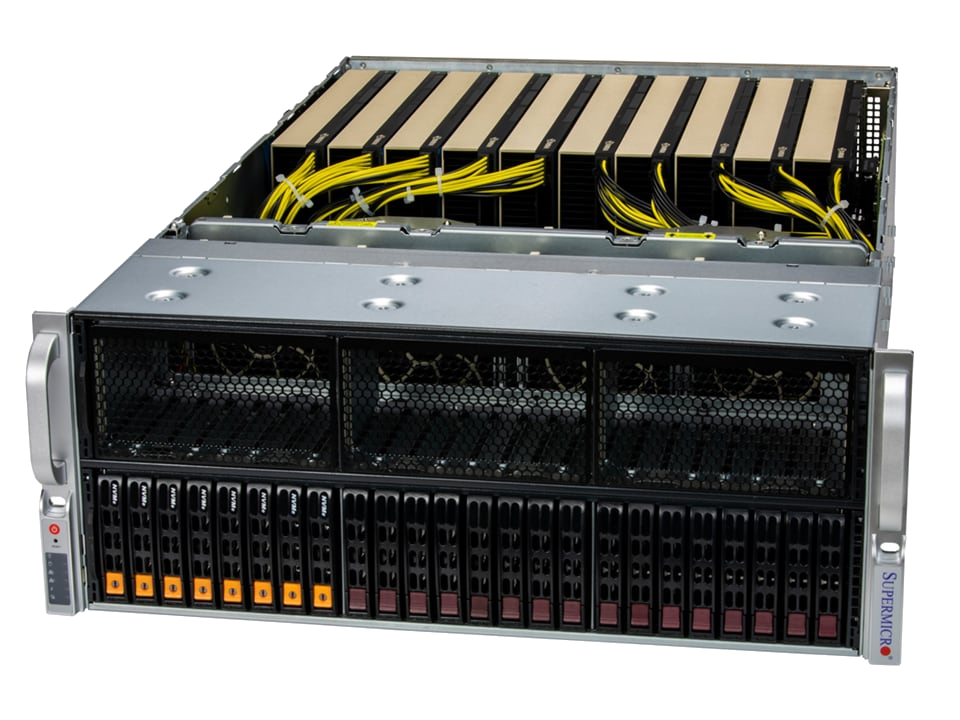
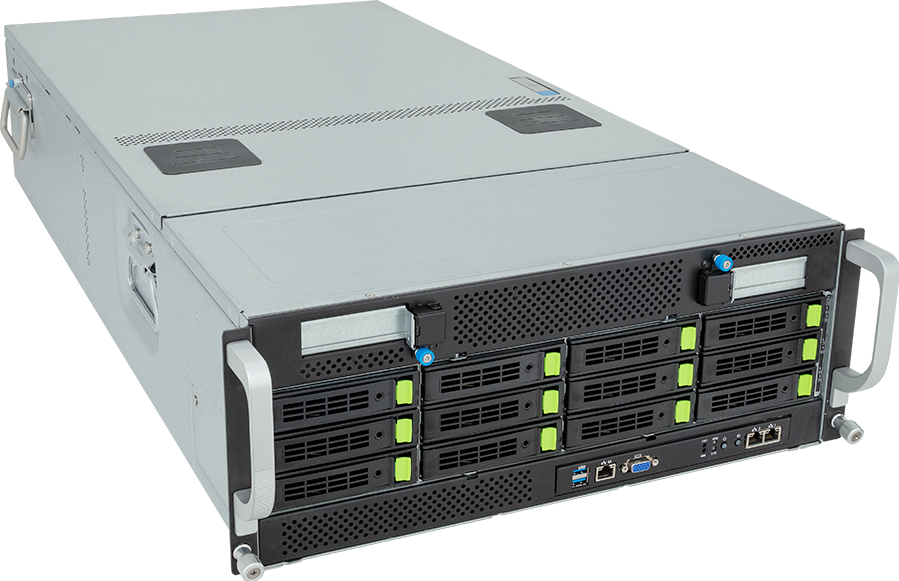
Zobacz szczegóły Wynajmujesz całą maszynę z kartami NVIDIA L40S na wyłączność, razem z procesorami, pamięcią i dyskami, a nie wirtualny wycinek karty ani wirtualne rdzenie na serwerze dzielonym z innymi klientami. Wynajem NVIDIA L40S 48 GB obejmuje serwery rackowe ASUS, Supermicro i Gigabyte z dwiema, czterema albo ośmioma kartami. Na tej stronie L40S oznacza serwerową kartę graficzną NVIDIA z 48 GB pamięci GDDR6 z korekcją błędów, w generacji Ada Lovelace. Karta jest pasywna, bez wyjść wideo, i pracuje w kadłubie rackowym w zestawach po dwie, cztery albo osiem sztuk — w katalogu stoi 7 gotowych obsad, od pary kart po osiem sztuk z 384 GB pamięci graficznej łącznie. Opłata jest stała i miesięczna: kwota nie zależy od liczby przepracowanych godzin. W przeliczeniu na jedną kartę wychodzi 4,60 zł/h, choć rozliczenie zostaje miesięczne. Najmu na godziny nie prowadzimy: stawka godzinowa to wyłącznie przeliczenie, pomocne przy porównaniu z usługami rozliczanymi z licznikiem. W takim porównaniu licznik godzinowy dogania stałą opłatę po pewnej liczbie przepracowanych godzin, a powyżej tego progu każda kolejna godzina jest już w cenie.
Przeglądaj katalog →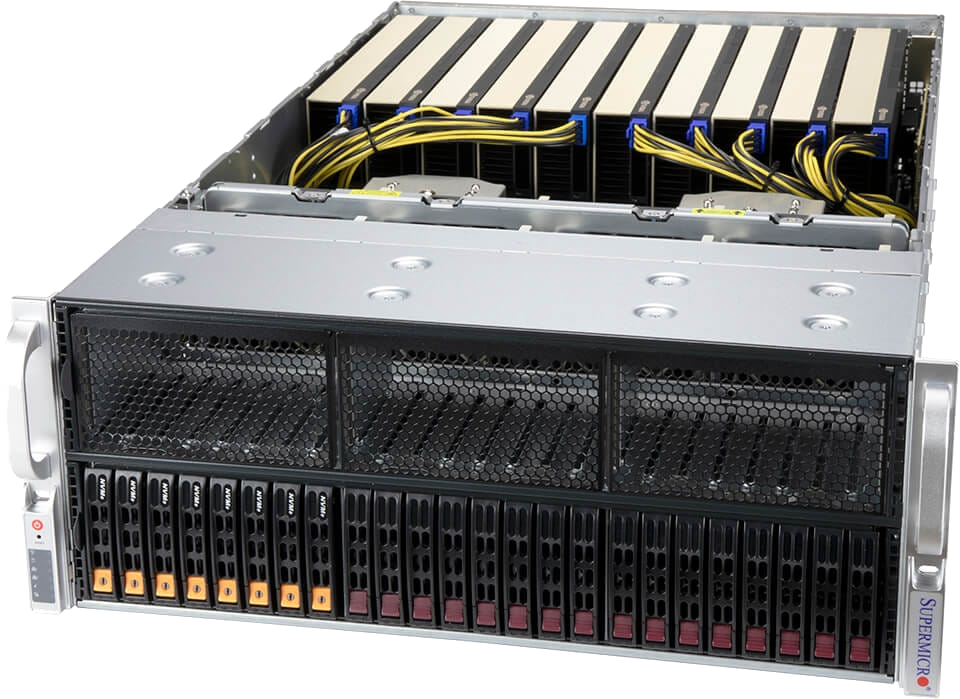
Pamięć karty decyduje o tym, co da się załadować w całości, a liczba kart — ile takich zadań pójdzie równolegle.
SDXL i ComfyUI z kompletem ControlNetów, upscalerem i modelem wideo trzymanym w pamięci między zadaniami. Ten sam zapas obsługuje inferencję modeli językowych do kilkunastu miliardów parametrów w pełnej precyzji.
Rendering produkcyjny w Redshift, Octane albo V-Ray: dwie klatki liczone równolegle albo jedna scena rozdzielona na kafle. Sceny wizualizacji architektonicznych z teksturami 8K mieszczą się bez wymiany danych z pamięcią systemową.
Farma renderująca dla zespołu i jednoczesna inferencja modeli 30B w kwantyzacji 8-bitowej. Cztery niezależne kolejki zadań na jednej maszynie, każda z własną kartą.
Wsadowe generowanie wideo, transkodowanie sprzętowymi silnikami NVENC i obsługa wielu użytkowników naraz. Osiem kolejek renderujących albo osiem instancji modelu za jednym adresem.
L40S wobec NVIDIA A100 80 GB. A100 ma 80 GB pamięci HBM2e i mechanizm MIG, który dzieli jedną kartę na mniejsze instancje — to sprzęt pod trening i wsadową inferencję dużych modeli. L40S ma 48 GB GDDR6 z ECC, rdzenie RT i sprzętowe silniki wideo, których A100 nie ma w ogóle. Do renderingu, generatywnej grafiki i transkodowania L40S jest właściwym wyborem, do treningu modeli powyżej 30B — serwer z A100.
L40S wobec RTX PRO 6000 Blackwell Server Edition. Nowsza karta ma 96 GB GDDR7, czyli dwa razy tyle pamięci na sztukę, i architekturę Blackwell. L40S zostaje przy Ada Lovelace i niższej opłacie — osiem kart L40S daje tyle samo pamięci graficznej co cztery karty RTX PRO 6000. Zestawienie obu obsad: serwer RTX PRO 6000 Blackwell SE.
Co obejmuje stawka. W naszym cenniku para kart kosztuje od 6 723 zł netto/mies. (8 269 zł brutto), a abonament obejmuje port 2,5 Gbit/s gwarantowany i 20 TB transferu wychodzącego.
Maszyny z kartami NVIDIA L40S 48 GB obsadzamy dwiema, czterema albo ośmioma kartami, z pamięcią systemową od 256 GB do 3 TB i dyskiem NVMe od 0,40 do 7,68 TB. Liczba konfiguracji w tej rodzinie: 7. Stawka jest miesięczna i obejmuje całą maszynę fizyczną: od 6 723 zł netto (8 269 zł brutto) do 32 868 zł netto (40 428 zł brutto). Sprzęt pracuje w serwerowni na terenie Unii Europejskiej, jedna maszyna ma jednego najemcę.
L40S z rodziny Ada Lovelace łączy rdzenie RT, rdzenie Tensor i sprzętowe kodery wideo z 48 GB pamięci GDDR6 z korekcją błędów. Jedna karta obsłuży rendering, model generatywny i transkodowanie, więc ta rodzina najczęściej trafia do studiów graficznych i zespołów pracujących z obrazem.
Liczba kart wynika z tego, ile zadań ma iść równolegle. Pamięć kart sumuje się w tabeli, ale nie w pojedynczym zadaniu: na magistrali PCIe bez mostka NVLink każdy model musi zmieścić się w 48 GB albo zostać podzielony programowo. Pamięć systemowa rośnie razem z liczbą kart, bo każdy proces roboczy trzyma własną kopię danych wejściowych. Warianty z 1 TB i 3 TB RAM powstały pod sceny i zbiory, które przestają mieścić się w 768 GB.
Wybór dysku działa podobnie: wariant z 0,40 TB NVMe zakłada, że materiał źródłowy leży na zewnętrznym zasobie, a warianty z 7,6 TB przewidziano pod lokalne repozytorium tekstur, cache i wyników renderu. Pełne parametry każdej konfiguracji stoją w tabeli powyżej; opis samej karty prowadzimy na stronie NVIDIA L40S.
W katalogu L40S sąsiaduje z dwiema kartami o tej samej pojemności pamięci. RTX A6000 daje te same 48 GB w niższej stawce miesięcznej, na starszej generacji Ampere i bez kodera nowej generacji. RTX PRO 5000 Blackwell daje 48 albo 72 GB i nowszą generację rdzeni Tensor. Wybór sprowadza się do tego, czy w zadaniu decyduje przepustowość renderu i kodowania (L40S), sprawdzona generacja Ampere bez potrzeby FP8 (A6000), czy generacja rdzeni i większy bufor (RTX PRO 5000).
Nasze stawki dla tej rodziny mieszczą się między 6 723 zł netto (8 269 zł brutto) a 32 868 zł netto miesięcznie (40 428 zł brutto) za całą maszynę, bez licznika godzin, z transferem wychodzącym do 20 TB miesięcznie w cenie. Przy zobowiązaniu na 6 albo 12 miesięcy opłata spada; obie wartości podajemy w bloku cenowym przy każdej konfiguracji.
L40S to karta serwerowa generacji Ada z 48 GB pamięci, rdzeniami RT i sprzętowymi koderami wideo. Przy renderingu na GPU, czyli scenach produktowych, animacjach i wizualizacjach architektonicznych, geometria, tekstury i bufory sceny powinny zmieścić się w pamięci jednej karty. W serwerze z kilkoma kartami każda z nich liczy osobną klatkę albo osobne zadanie z kolejki.
Wynajmujesz całą fizyczną maszynę w profesjonalnej serwerowni, nie maszynę wirtualną. Masz pełne uprawnienia administratora, więc sam instalujesz sterowniki, programy i menedżer kolejki renderingu. Programy do renderingu wraz z licencjami wnosi klient.
Serwer rack z kartą L40S kosztuje od 6 723 zł netto (8 269 zł brutto) miesięcznie. Jeśli sceny mieszczą się w pamięci karty stacyjnej, tańszym startem jest stacja robocza do renderingu z kartą RTX A albo RTX PRO Blackwell.
48 GB GDDR6 z korekcją błędów ECC. W konfiguracji dwukartowej daje to 96 GB, w czterokartowej 192 GB, a w ośmiokartowej 384 GB pamięci graficznej na maszynę.
Fine-tuning modeli do kilkunastu miliardów parametrów z adapterami LoRA mieści się na jednej karcie, a na czterech kartach — pełny fine-tuning modeli klasy 13B. Trening od zera dla modeli 70B i większych to zadanie dla pamięci HBM: A100 albo H200. Pamięć potrzebną dla modeli innej wielkości i precyzji liczy poradnik ile VRAM potrzebuje LLM.
Zależy od silnika i geometrii sceny. Osiem kart pozwala liczyć osiem klatek równolegle albo jedną klatkę rozdzieloną na kafle. Czas dla konkretnego projektu policzymy na Państwa scenie w ramach wyceny.
To ta sama generacja Ada Lovelace i ta sama pojemność 48 GB. L40S jest kartą serwerową z chłodzeniem pasywnym i bez wyjść wideo, RTX 6000 Ada ma własny wentylator i złącza monitorowe do pracy przy stacji. Szczegóły: RTX 6000 Ada w wynajmie.
Wszystkie liczące na CUDA i OptiX — Redshift, Octane, V-Ray i Cycles. Karta udostępnia też sprzętowe kodowanie NVENC, z którego korzystają pipeline'y transkodujące wideo.
Sam model SDXL mieści się w 24 GB. Pozostałe 24 GB na karcie L40S przyjmują ControlNety, upscalery i modele wideo, dzięki czemu cały graf ComfyUI działa bez wyładowywania modeli między krokami.
Tak. Obok stawki miesięcznej w tabeli cen stoją stawki dla umowy sześciomiesięcznej i dwunastomiesięcznej — dla każdej konfiguracji osobno.
Port 2,5 Gbit/s gwarantowany z 20 TB transferu wychodzącego w cenie, adresację IPv4 i IPv6 oraz konsolę KVM-over-IP od chwili uruchomienia maszyny; zmiany w BIOS/UEFI wykonujemy na zlecenie. Opłata wdrożeniowa jest jednorazowa, podana przy każdej konfiguracji i pobierana przy najmie na 1 i 6 miesięcy; przy umowie na 12 miesięcy jej nie ma.
Termin uruchomienia potwierdzamy w ofercie — data zależy od wybranej obsady kart i pamięci.
Stawka obejmuje całą maszynę, a nie same karty. Wariant ośmiokartowy z 768 GB RAM i 2 TB NVMe ma skromniejszą pamięć, dysk i procesory niż wariant czterokartowy z 1 TB RAM, 3,80 TB NVMe i 96 rdzeniami fizycznymi, dlatego kolejność cen w tabeli nie idzie za samą liczbą kart.
768 GB to punkt wyjścia, który daje po 96 GB na proces roboczy. 1 TB zostawia zapas na cache scen i wielu użytkowników pracujących naraz. 3 TB przewidziano pod symulacje i zbiory danych ładowane w całości do pamięci, gdzie karty czekają na dane z procesora.
Nie, karty pracują na magistrali PCIe, a ruch między nimi idzie przez przełącznik PCIe w kadłubie. Dla renderingu i inference z jednym modelem na kartę to układ naturalny, bo zadania są od siebie niezależne.
Przy kwantyzacji FP8 wagi zajmują mniej więcej tyle gigabajtów, ile model ma miliardów parametrów, więc 48 GB obsłuży model klasy 30B razem z buforem kontekstu. Model klasy 70B rozkłada się na dwie karty przy pomocy podziału tensorów.
Liczbą równoległych procesów roboczych obsługujących kolejkę. Cztery karty to cztery zadania naraz z jednego katalogu modeli, osiem kart podwaja przepustowość kolejki bez zmiany workflow. Same czasy pojedynczego zadania pozostają takie same, bo model i tak liczy się na jednej karcie.
Całą maszynę fizyczną z dostępem administracyjnym, na wyłączność jednego najemcy. Karty pracują w pełnej wielkości, z pełnym VRAM i pełnym limitem mocy, a zdalna konsola sprzętowa jest w cenie abonamentu.
Porównanie wszystkich kart: Karty GPU NVIDIA na wynajem — porównanie pamięci i cen

